

Hoje, apresentamos o Altar, o nosso primeiro modelo de segurança de pesos abertos, construído para trazer segurança defensiva de ponta para a infraestrutura que controla.
Demos o nosso primeiro passo em direção à inteligência de segurança soberana com o nosso dispositivo de pentest autónomo Aikido Machine, que é executado inteiramente dentro da própria infraestrutura do cliente, incluindo ambientes totalmente em air-gap. As equipas com regras estritas sobre manter o código internamente podem detetar, explorar e validar continuamente vulnerabilidades em toda a sua superfície de ataque sem infringir essas regras.
O Altar fornece ao Aikido Machine IA avançada que protege, sem enviar o contexto mais sensível de uma organização para um serviço de inferência de terceiros.
Para o fazer, precisámos de colmatar a lacuna de implementação. A maioria dos modelos de pesos abertos capazes continua a ser difícil de implementar à escala de produção, mantendo ao mesmo tempo a qualidade de raciocínio dos modelos de ponta.
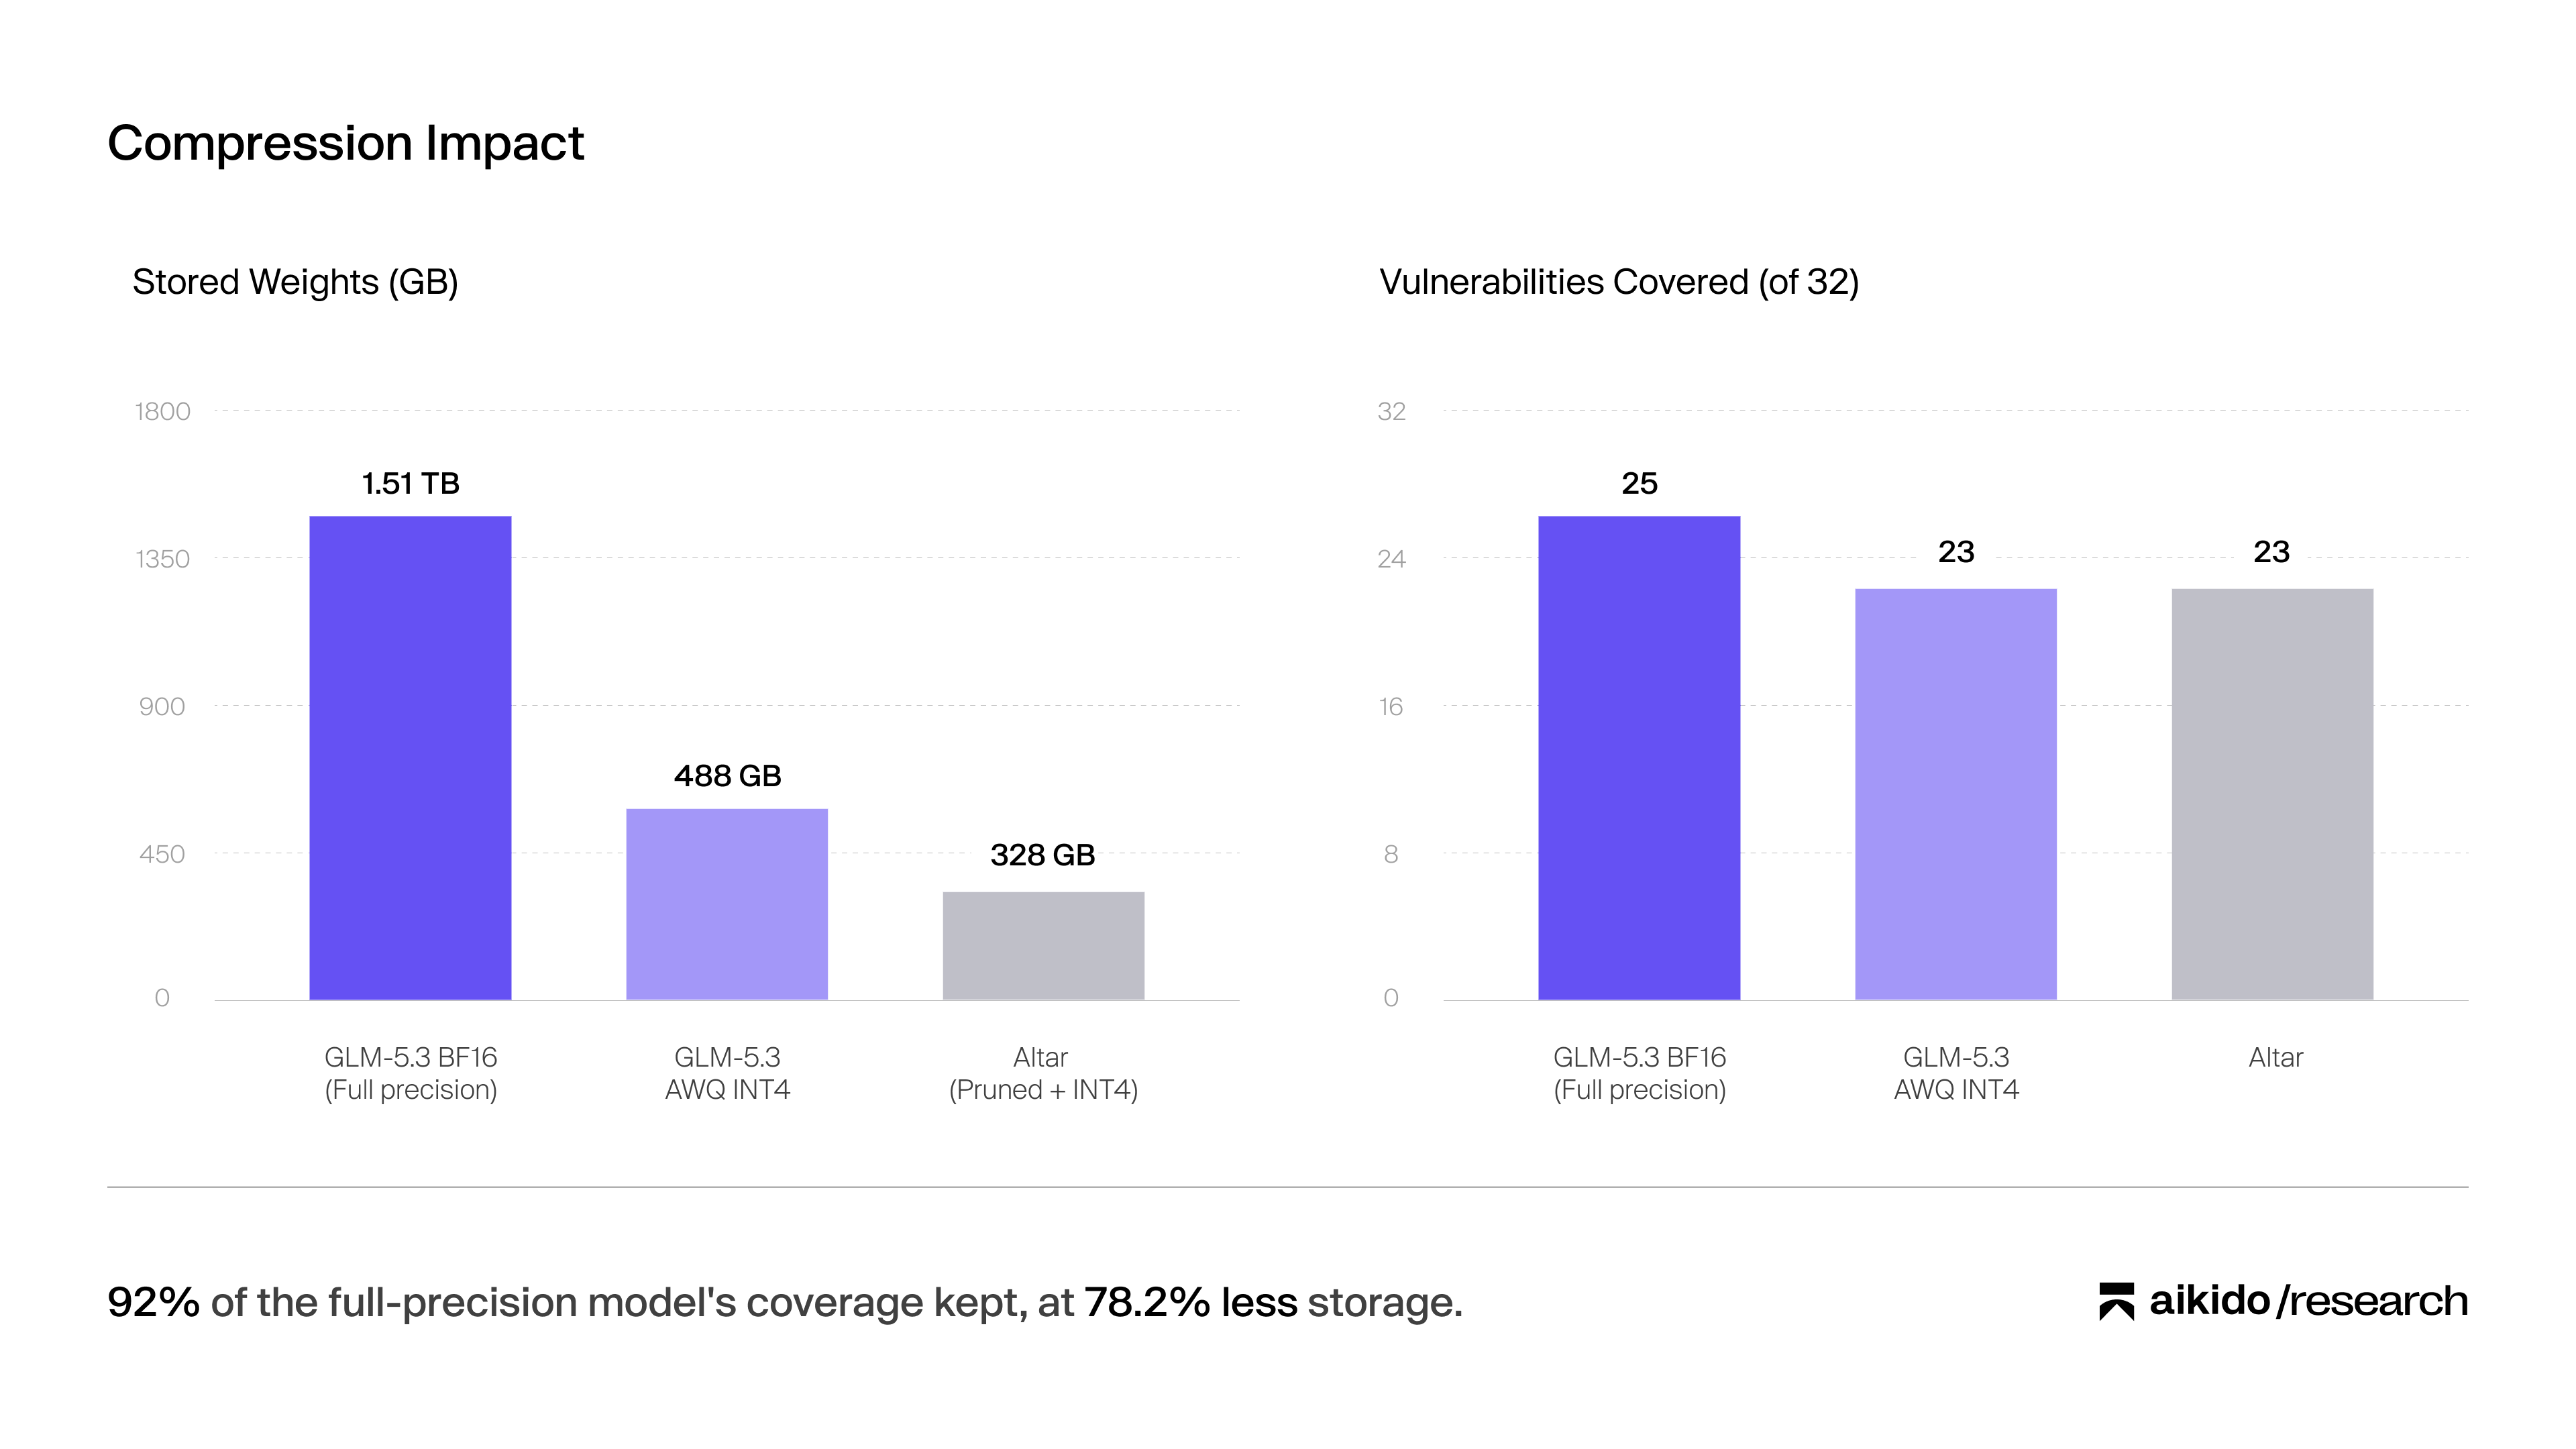
Começámos com o GLM-5.3, um dos modelos mais fortes nas nossas avaliações de segurança. O modelo completo ocupa 1,51 TB; a quantização reduz esse valor para 488 GB e o nosso processo de poda de peritos reduz-lo ainda mais para 328 GB, mantendo grande parte da qualidade de raciocínio do modelo original.
A diferença entre os modelos de fronteira e os modelos de pesos abertos explicada
Os modelos de fronteira fechados são executados na infraestrutura de terceiros
Utilizar um destes modelos significa que o seu código-fonte, a documentação da sua arquitetura interna e as suas descobertas por corrigir saem da sua rede. Para um banco sujeito a um mandato de residência de dados, um grupo hospitalar sujeito a regras estritas de processamento de dados ou um operador industrial cujo ambiente OT não tem qualquer rota para a internet, esta não é uma concessão que lhe seja permitida fazer.
A lacuna de implementação
Servir um modelo como o GLM 5.3 em precisão total requer centenas de gigabytes de memória unificada e resulta numa velocidade de inferência limitada ao servir conversas paralelas com janelas de contexto elevadas. Em termos humanos, são gigantescos.
Essas exigências de recursos devem-se, em parte, à forma como estes modelos são construídos. Muitos dos modelos mais potentes da atualidade utilizam arquiteturas de mistura de peritos (mixture-of-experts). Estes modelos são compostos por uma multiplicidade de pequenas redes neuronais especializadas, cada uma designada por perito. Apenas um pequeno número de peritos está ativo para cada token, enquanto o conjunto total de peritos ainda tem de ser armazenado e servido. Isso significa pagar um custo significativo de memória e infraestrutura por uma capacidade que pode contribuir muito pouco para a carga de trabalho que está realmente a executar.
O trabalho de segurança, tal como a revisão de código em busca de vulnerabilidades, a proposta de correções e a execução de um pentest, requer apenas uma pequena fração desse conjunto de peritos. Mas o custo de memória não diminui proporcionalmente: cada pedido continua a ter de carregar o modelo completo, quer seja relevante para a tarefa ou não.
Agora, adicione agentes à mistura e a utilização de contexto explode, o que satura a memória e faz com que os agentes concorram entre si por espaço. Cada um mantém um registo contínuo de tudo o que viu e fez, e esse registo permanece na memória da GPU juntamente com o próprio modelo, crescendo quanto mais tempo durar uma investigação e multiplicando-se por cada investigação executada em paralelo.
É por isso que o tamanho do modelo importa aqui: o modelo e todo esse contexto em crescimento recorrem ao mesmo pool fixo de memória, pelo que mais espaço ocupado por um significa menos espaço para o outro. O objetivo é tornar a operação de um modelo de fronteira mais eficiente para uma carga de trabalho específica, preservando as capacidades que importam e libertando capacidade para tudo o que corre em simultâneo.
O que podemos remover sem perder o que importa?
O pesado encargo de carregar tantos peritos num modelo pode ser transformado numa vantagem com as técnicas certas. De modo a minimizar o tamanho dos modelos de pesos abertos num contexto de segurança baseada em agentes, mantendo ao mesmo tempo uma elevada precisão, utilizámos a quantização e a poda.
A poda de peritos remove alguns dos peritos do modelo, tipicamente eliminando blocos de pesos de peritos inteiros e ajustando o modelo para que cada token escolha apenas entre os que permanecem. A remoção em si é mecânica. Decidir quais os peritos a remover é a parte difícil, e a perda pode ser desigual: um modelo mais pequeno pode reter um forte desempenho de codificação, perdendo grande parte da sua capacidade de compreender uma linguagem natural específica. Isso pode deixá-lo incapaz de interpretar de forma fiável a documentação, as regras de negócio ou as funcionalidades da aplicação descritas nessa linguagem.
Para decidir o que manter, começámos com o tipo de dados mais natural: os registos (traces) do nosso sistema de testes de penetração a executar benchmarks internos. Estes capturam o código, as chamadas de ferramentas e as respostas que os agentes processam durante um pentest completo, fornecendo-nos entradas representativas para orientar a seleção de peritos. Nunca foram envolvidos quaisquer dados de clientes.
Esta etapa de calibração fornece-nos uma base específica para a carga de trabalho no que toca à seleção de peritos, sem treinar novas competências no modelo.
Os traces do sistema cobriam a carga de trabalho técnica. Também precisávamos de preservar a compreensão de linguagem: investigar uma aplicação significa compreender as suas funcionalidades, regras de negócio e fluxos de trabalho pretendidos, incluindo quando a respetiva documentação ou interface está em francês, neerlandês ou noutra língua. Adicionámos, portanto, texto multilingue para ajudar a preservar essas capacidades durante a poda.
A seleção importa tanto como o tamanho
Existem muitas técnicas de poda para reduzir a pegada de LLMs, pelo que decidimos optar por uma técnica capaz de preservar o desempenho para os nossos casos de uso: Cerebras REAP, Router-weighted Expert Activation Pruning (Poda de Ativação de Peritos Ponderada por Router). Utilizámos a pontuação de contribuição do REAP com uma estratégia de agregação que preserva o domínio, selecionada através de testes de fidelidade. Contar a frequência com que um perito é selecionado fornece apenas uma parte do panorama. O REAP estimativa a sua contribuição utilizando tanto a ponderação do router como a magnitude da saída do perito.
Também analisamos as contribuições em diferentes grupos de exemplos. Caso contrário, uma capacidade importante para uma carga de trabalho menos comum pode perder-se numa média geral. As capacidades de cibersegurança, codificação e linguagem estão distribuídas por vários peritos; não existe um conjunto claramente rotulado de "peritos cibernéticos" para manter ou descartar.
No estudo de compressão de apoio, os modelos que retinham o mesmo número de peritos diferiam substancialmente na proximidade com que as suas saídas seguiam o modelo de referência. O tamanho isolado não determinou o que sobreviveu.
De 1,51 TB para 328 GB
Conseguimos uma redução total de 78,2% no tamanho do modelo em comparação com o GLM 5.3 em precisão total, e uma redução de 32,8% em comparação com o GLM 5.3 com uma quantização AWQ INT4. O Altar retém 168 dos 256 peritos encaminhados originais em cada camada de peritos principal, removendo 88, ou seja, 34.4% dos mesmos. O router continua a selecionar oito por token, agora a partir do banco mais pequeno.
A outra parte da redução provém da quantização. Os pesos de um modelo são os valores numéricos que este aprende durante o treino. A quantização armazena esses números com menos bits, trocando alguma precisão por pesos armazenados mais pequenos. Ao contrário da poda, não remove peritos.
O nosso ponto de verificação inicial utilizou AWQ para armazenar a maioria dos pesos dos peritos em quatro bits em vez dos dezasseis do modelo BF16. O AWQ utiliza informações sobre a atividade do modelo em dados de entrada de exemplo para limitar os erros introduzidos por uma menor precisão. Os valores intermédios produzidos durante a inferência, chamados ativações, permanecem a 16 bits: daí o termo W4A16, ou seja, pesos de quatro bits e ativações de 16 bits. Alguns pesos também retêm uma precisão superior. Em seguida, aplicámos a poda a este ponto de verificação já quantizado.
A comparação de ambas as representações principais mostra o que cada etapa aporta:
Isto representa menos 78,2% de armazenamento em comparação com o modelo completo de 16 bits. Face ao modelo principal já quantizado, a poda remove mais 160 GB, uma redução de 32,8%.
O impacto da compressão nas capacidades de identificação de vulnerabilidades
Criámos anteriormente um benchmark de CVE interno que utilizamos para avaliar a capacidade de um modelo para identificar vulnerabilidades complexas do mundo real utilizando o nosso sistema de análise de código com IA: 32 vulnerabilidades conhecidas em 30 repositórios, com três ejecuções por caso.
Executámos o Altar contra o mesmo. O Altar obteve uma recuperação média de 60,4% por execução e rediscutiu 23 das 32 vulnerabilidades pelo menos uma vez em três ejecuções.
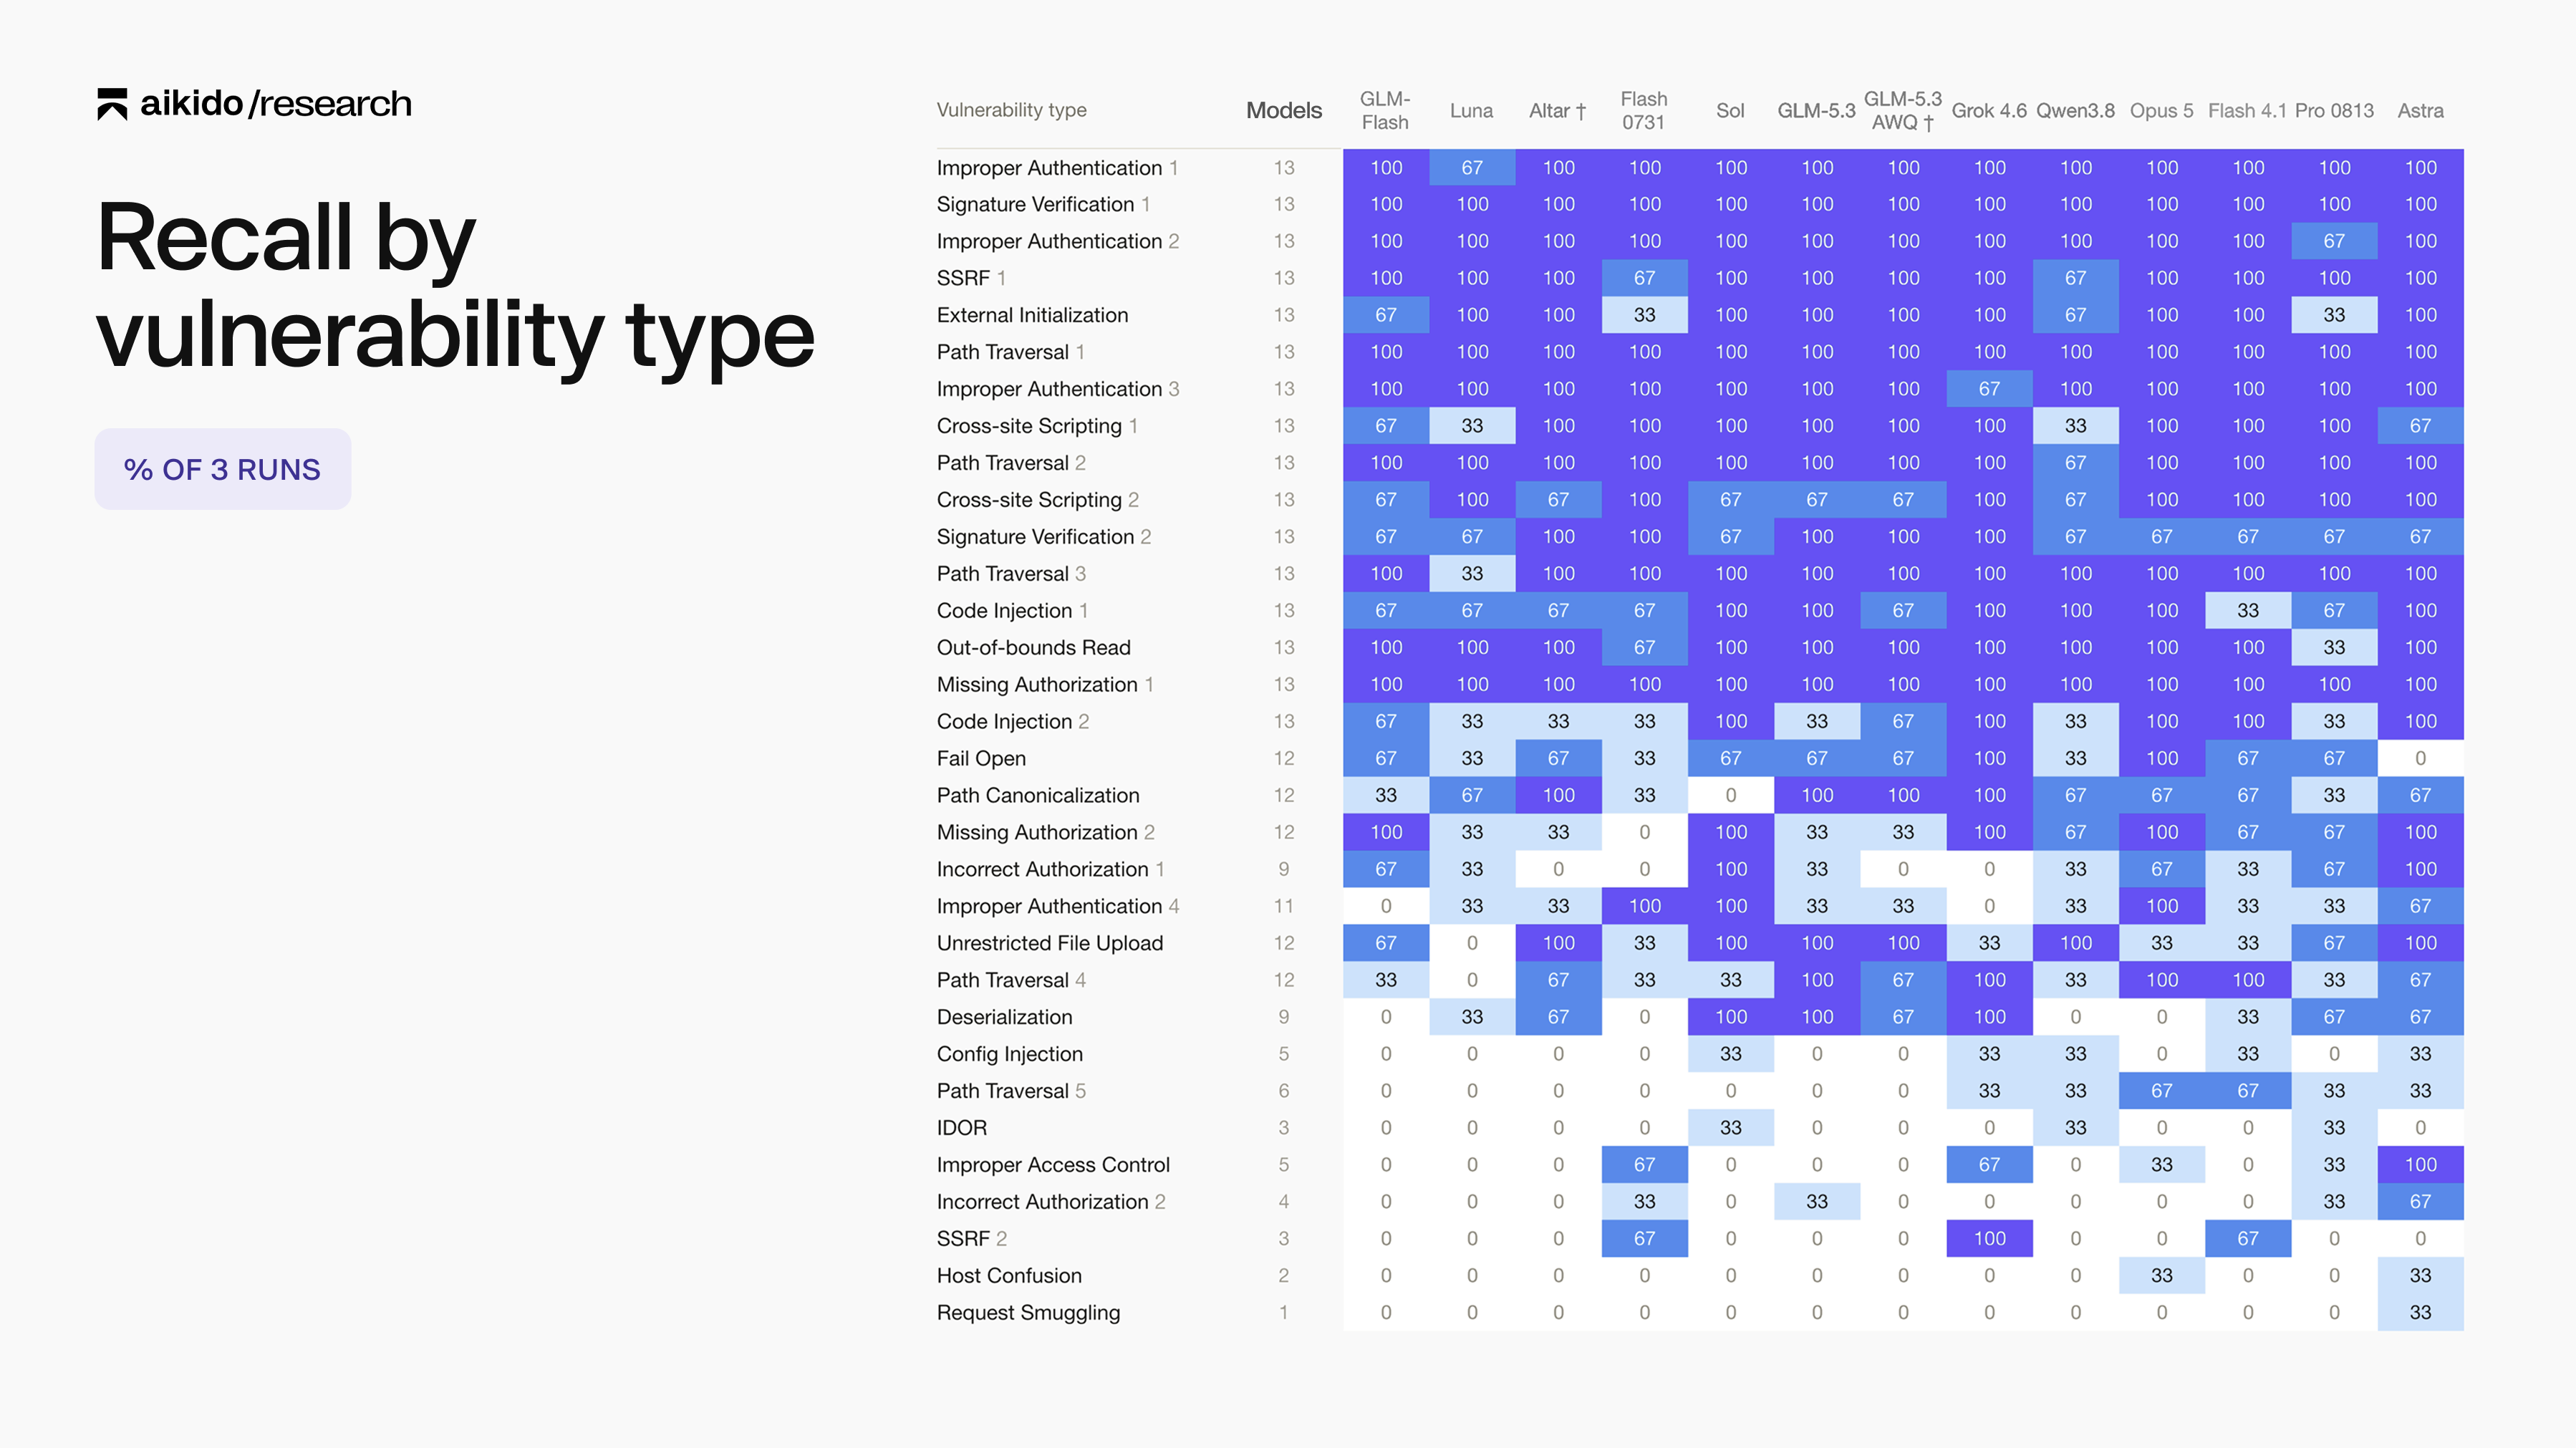
Em comparação, o modelo GLM-5.3 AWQ quantizado registou, em média, 61,5% de recall e abrangeu as mesmas 23 vulnerabilidades. O modelo GLM-5.3 original, com precisão total, registou, em média, 65,6% de recall e abrangeu 25 das 32 vulnerabilidades.
Por outras palavras, reduzir o ponto de controlo já quantizado de 488 GB para 328 GB, uma redução de 32,8% nos pesos armazenados, resultou numa recuperação média inferior em aproximadamente um ponto percentual em comparação com a linha de base AWQ, mantendo toda a sua cobertura de vulnerabilidades. Em comparação com o modelo principal original, o Altar reteve 23 das 25 vulnerabilidades cobertas, ou seja, 92%, com uma diminuição de 5,2 pontos percentuais na recuperação média. Isto corresponde a 92% da cobertura de vulnerabilidades do modelo principal mantida com menos 33% de armazenamento.
Esse é o compromisso que procurávamos: um modelo materialmente mais pequeno, preservando a maioria da capacidade de segurança do modelo principal.
Relatamos a recuperação média por execução separadamente da cobertura em três ejecuções: encontrar uma vulnerabilidade uma vez é diferente de a encontrar de forma consistente. As ejecuções concluídas sem resultados contam como falhas; as ejecuções incompletas são reportadas separadamente.
Isto mede a rediscolberta direcionada de CVE num pipeline que utiliza outros modelos para as fases envolventes. Não mede a descoberta cega em toda a base de código, não executa exploits para validar descobertas nem avalia a fase de proposta de correção. Estes limites mantêm o benchmark distinto do fluxo de trabalho de pentest mais amplo que estamos a criar para suportar o Altar.
Além disso, implementámos o Altar na nossa frota Aikido Machine imediatamente após concluir estas avaliações. Pouco depois da implementação, este identificou uma vulnerabilidade válida de severidade crítica durante um pentest de produção de um cliente.
{{cta}}
O que se segue
A ideia subjacente é mais abrangente: a inteligência de segurança soberana deve ser executada dentro de qualquer ambiente que protege.
O Altar é apenas o começo. No que respeita à compressão, estamos a explorar formatos de menor número de bits, como o EXL3, que nos poderiam permitir reter mais especialistas, juntamente com outras otimizações de servidores H200.
O próximo passo consiste em ir além da compressão para o treino: afinar modelos para fluxos de trabalho de segurança, melhorar a utilização de ferramentas e o raciocínio de longo prazo, e construir um pipeline de autoaprendizagem informado pelos nossos benchmarks internos para orientar e moldar futuros modelos.
Esse trabalho abrangerá a investigação de vulnerabilidades, a análise de código, a remediação e outros fluxos de trabalho de segurança defensiva.
O Aikido Labs existe para continuar a expandir esses limites: modelos que se tornam mais capazes ao longo do tempo sem perder a restrição que importa: os defensores têm de conseguir executá-los inteiramente dentro dos ambientes que são responsáveis por proteger.
Um agradecimento à Z.AI pelo GLM-5.3, à Cerebras pelo REAP, à cyanwiki pelo modelo quantizado e a 0xSero pelo trabalho de compressão. O estudo de fidelidade público e planos de retenção e o toolkit de poda fornecem mais detalhes técnicos, sem publicar conversas de agentes em bruto.
Os pesos do Altar estão disponíveis na organização da Aikido. O Altar pode ser implementado e executado comodamente utilizando um nó de 4-H200s e a versão mais recente do vLLM. Transfira o Altar para obter a ficha técnica do modelo, a licença, os parâmetros de execução e as instruções de implementação.
Precisa de ajuda para o executar no seu próprio ambiente? Contacte Vendas para falar sobre a implementação do Altar on-prem.
A abordagem está a expandir-se por toda a linha de produtos da Aikido, incluindo Aikido Attack (pentest de IA), Code Security Audit e Deep PR Review.




