Queimámos 11,7 mil milhões de tokens para encontrar o melhor modelo de IA cibernética
O GLM5.3 e o DeepSeek são agora modelos de nível de topo (frontier-tier)
Quer ver os benchmarks mais recentes? Consulte o Aikido Arena, que atualizamos regularmente.
Gastámos 11,7 mil milhões de tokens para avaliar as capacidades cibernéticas de 10 modelos de IA com três tentativas cada, utilizando 32 vulnerabilidades recentes prontas a usar para redescobrir.
Este teste de referência (benchmark) é uma evolução do nosso teste de referência de CVEs conhecidas anterior com um conjunto de dados novo e mais difícil, mais modelos e uma análise mais detalhada do que encontram, com que fiabilidade o fazem, bem como as suas particularidades e compromissos.
Com isto, adicionamos o GLM-5.3, o DeepSeek V4 Pro 0813, o DeepSeek V4 Flash 0731, o Qwen3.8-Max, o Kimi K3 e o Grok 4.6 à nossa seleção.
TL;DR:
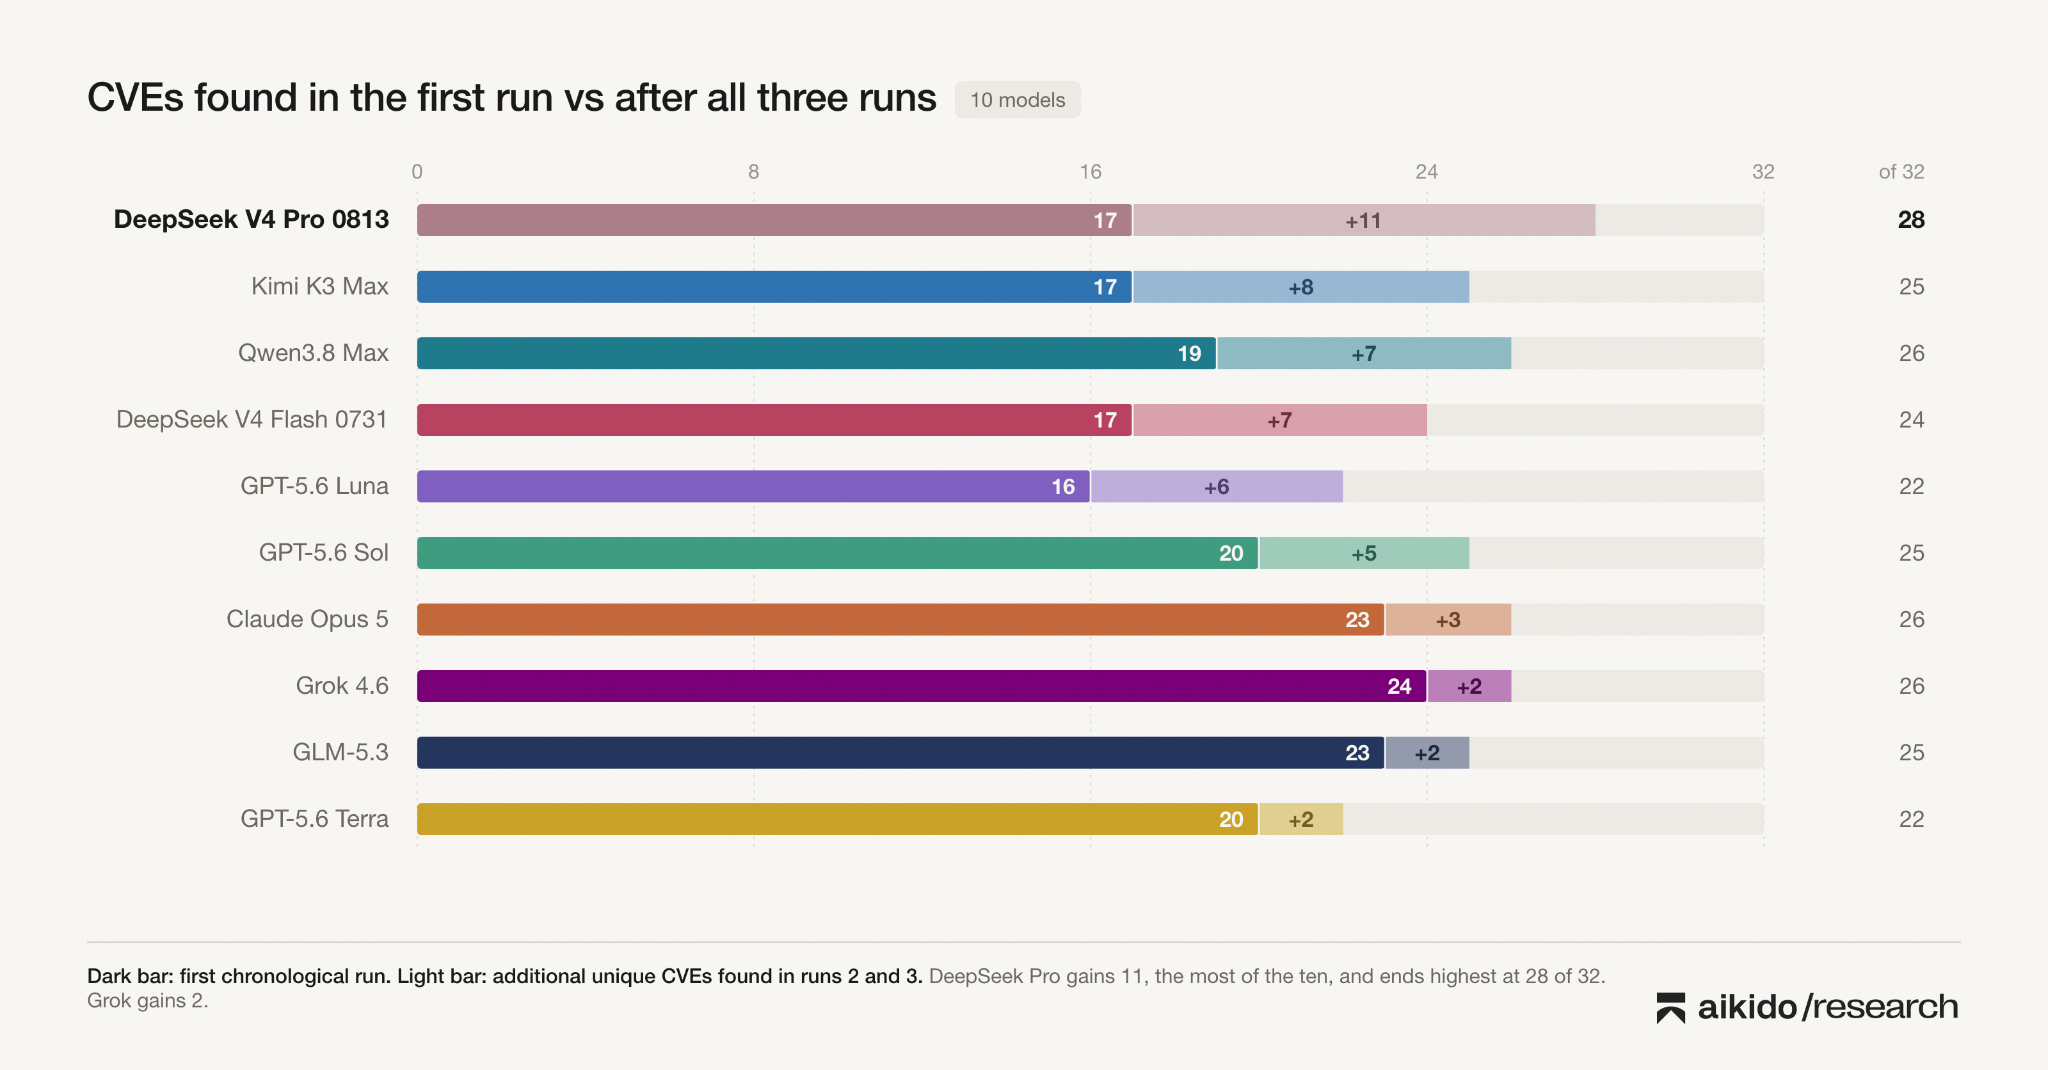
O DeepSeek V4 Pro 0813 encontra o maior número de vulnerabilidades. Ao juntar três execuções, atinge 28 de 32 vulnerabilidades.
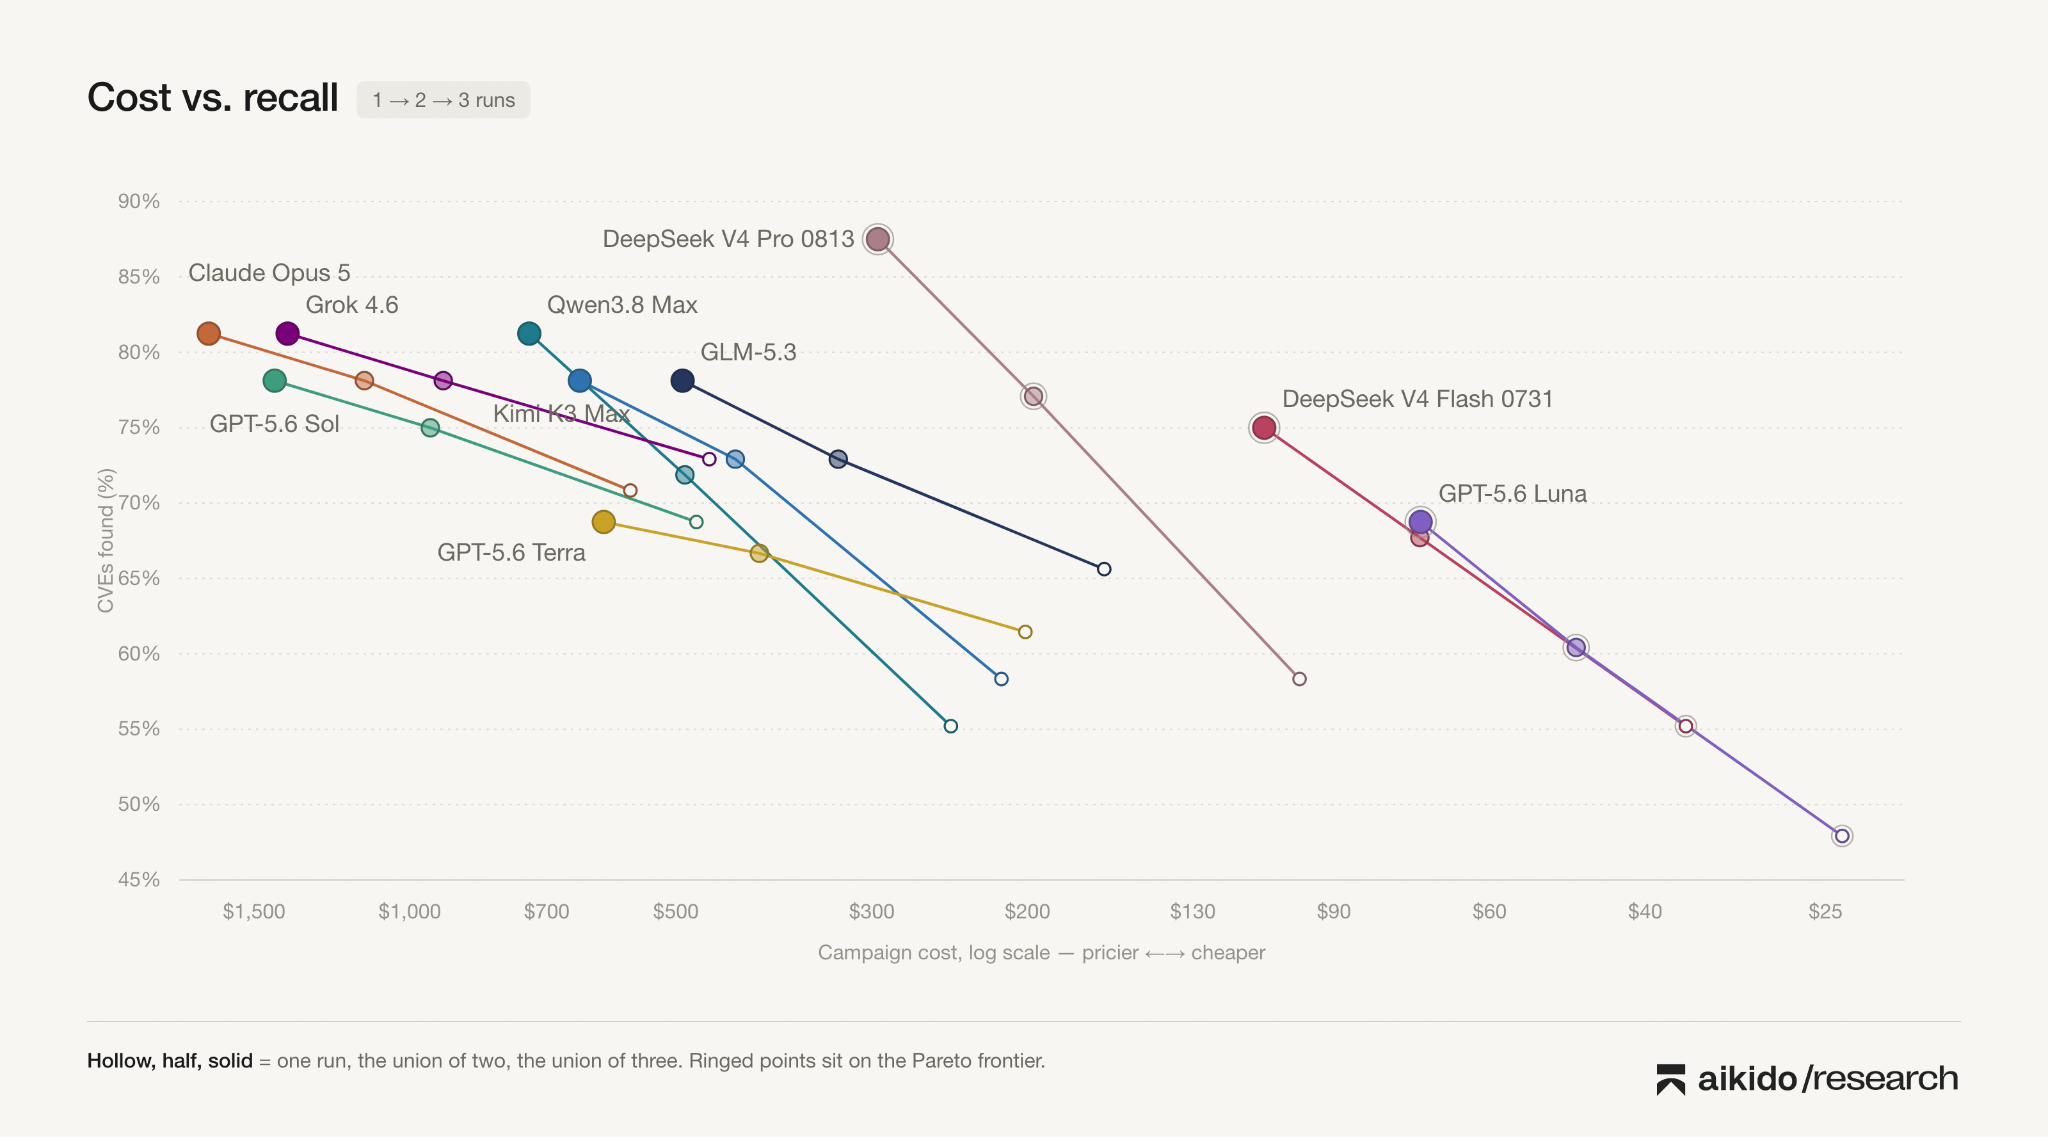
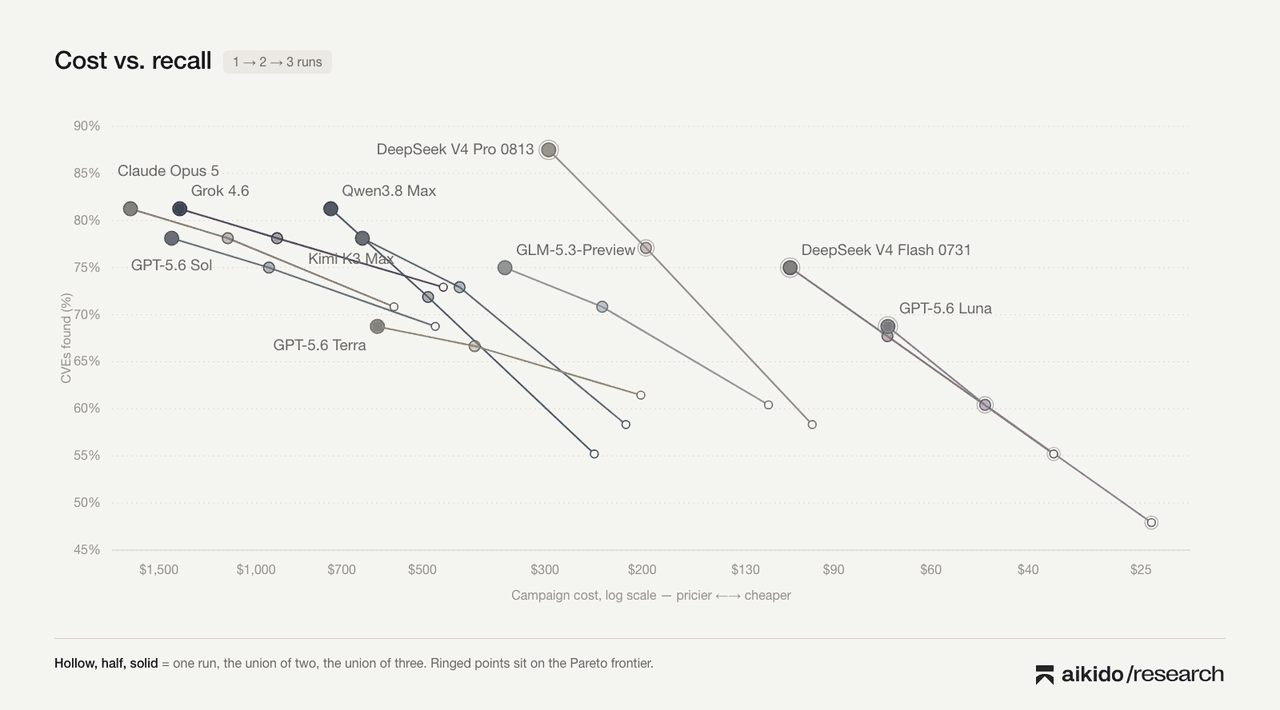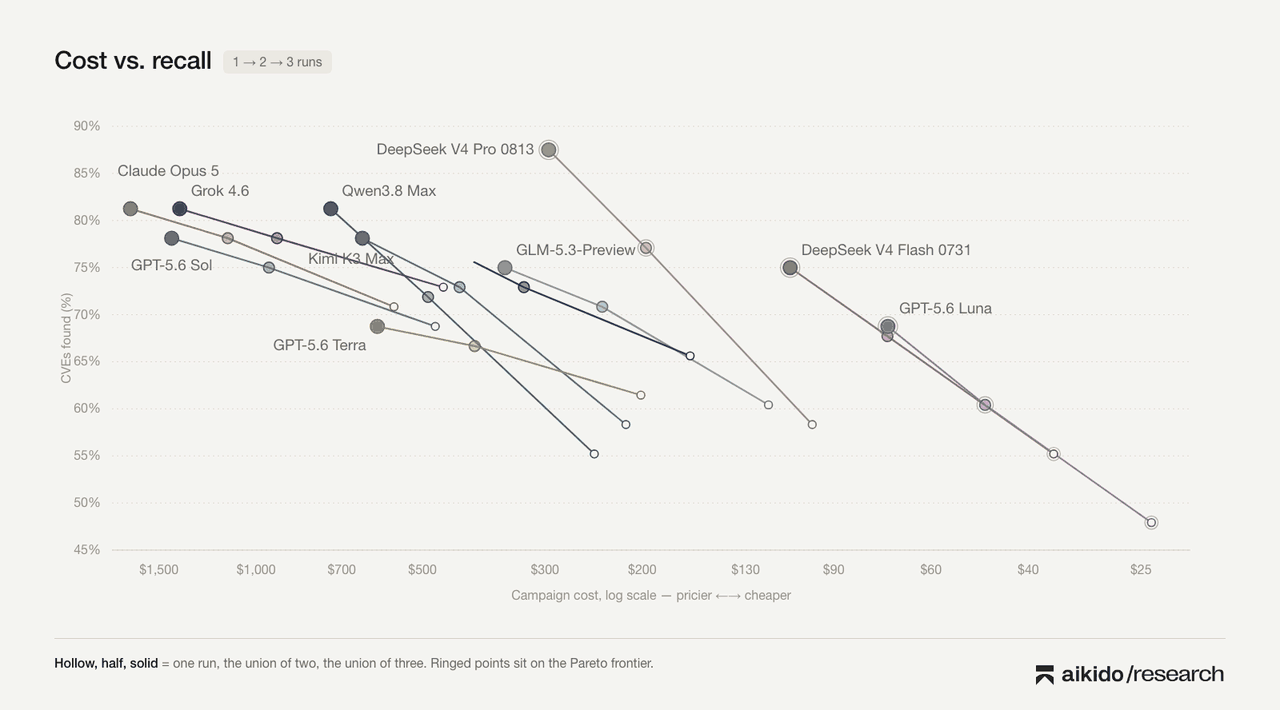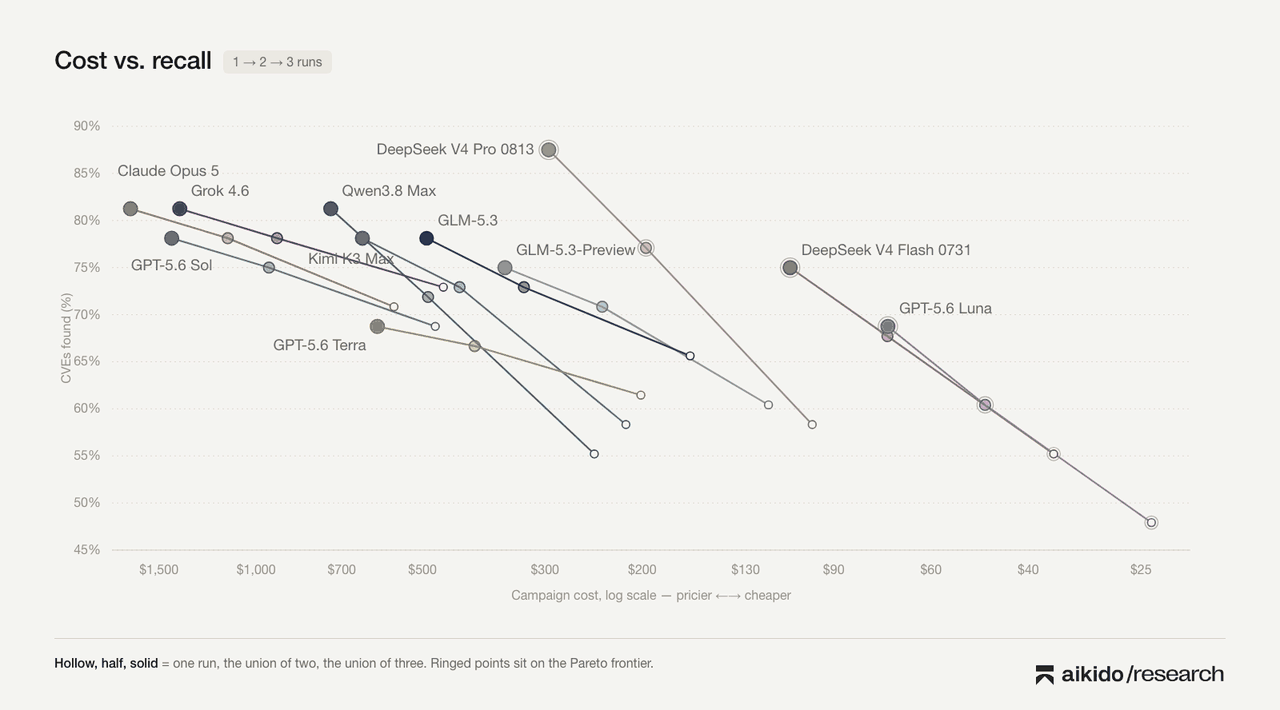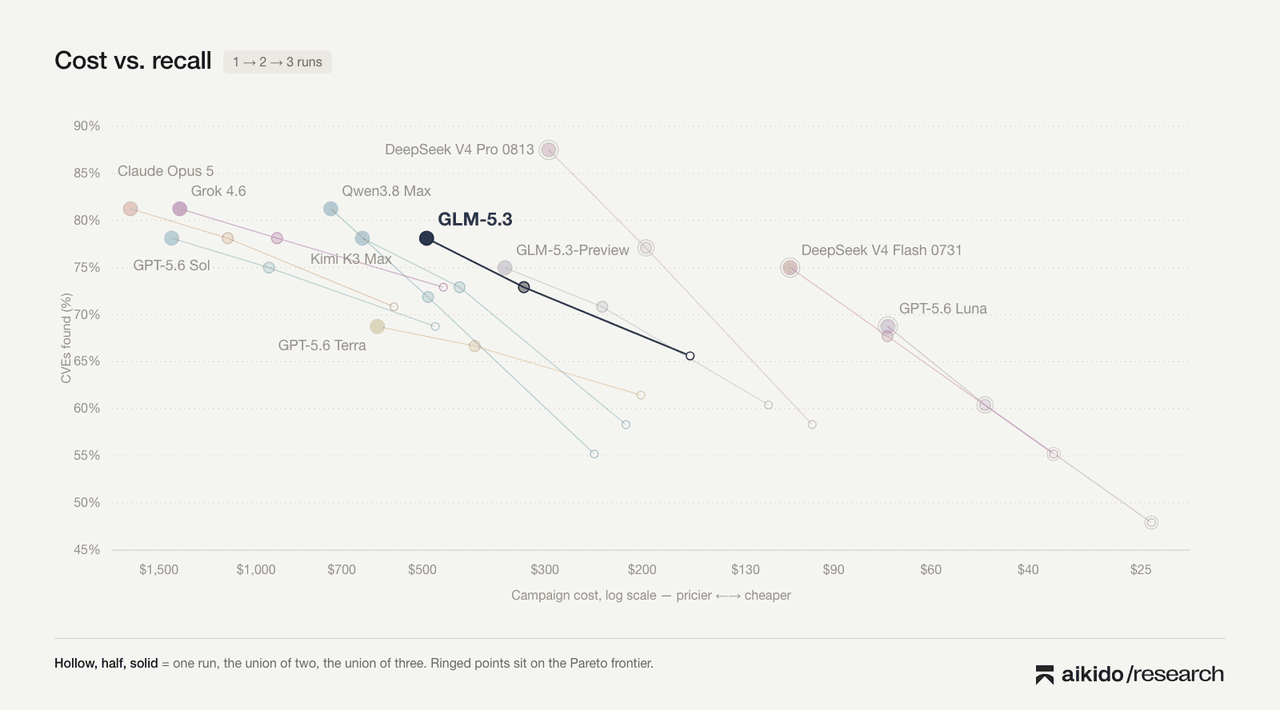
O modelo mais caro não é necessário. Três execuções do DeepSeek Pro custam cerca de 295 dólares e superam o Opus 5, o Grok 4.6 ou o Sol. Três execuções do Flash custam 108 dólares e chegam a 24, igualando a melhor execução individual do Grok por menos de um quarto do custo.
Os modelos são inconsistentes na recuperação (recall); a repetição corrige isso. Execuções individuais deixam escapar a amplitude de descobertas, mas a agregação de várias execuções preenche essa lacuna. O DeepSeek Pro encontra 17 vulnerabilidades na primeira passagem, mas 28 em três passagens.
Os modelos de código aberto superam agora a vanguarda pública. O DeepSeek V4 Pro superou todos os modelos fechados públicos que testámos na recuperação agregada de vulnerabilidades. O Qwen, o Kimi e o GLM-5.3 seguiram-se com uma forte consistência nas descobertas, sem perder capacidade de recuperação. Se forem devidamente explorados, os modelos abertos podem agora competir diretamente com os modelos de vanguarda fechados.
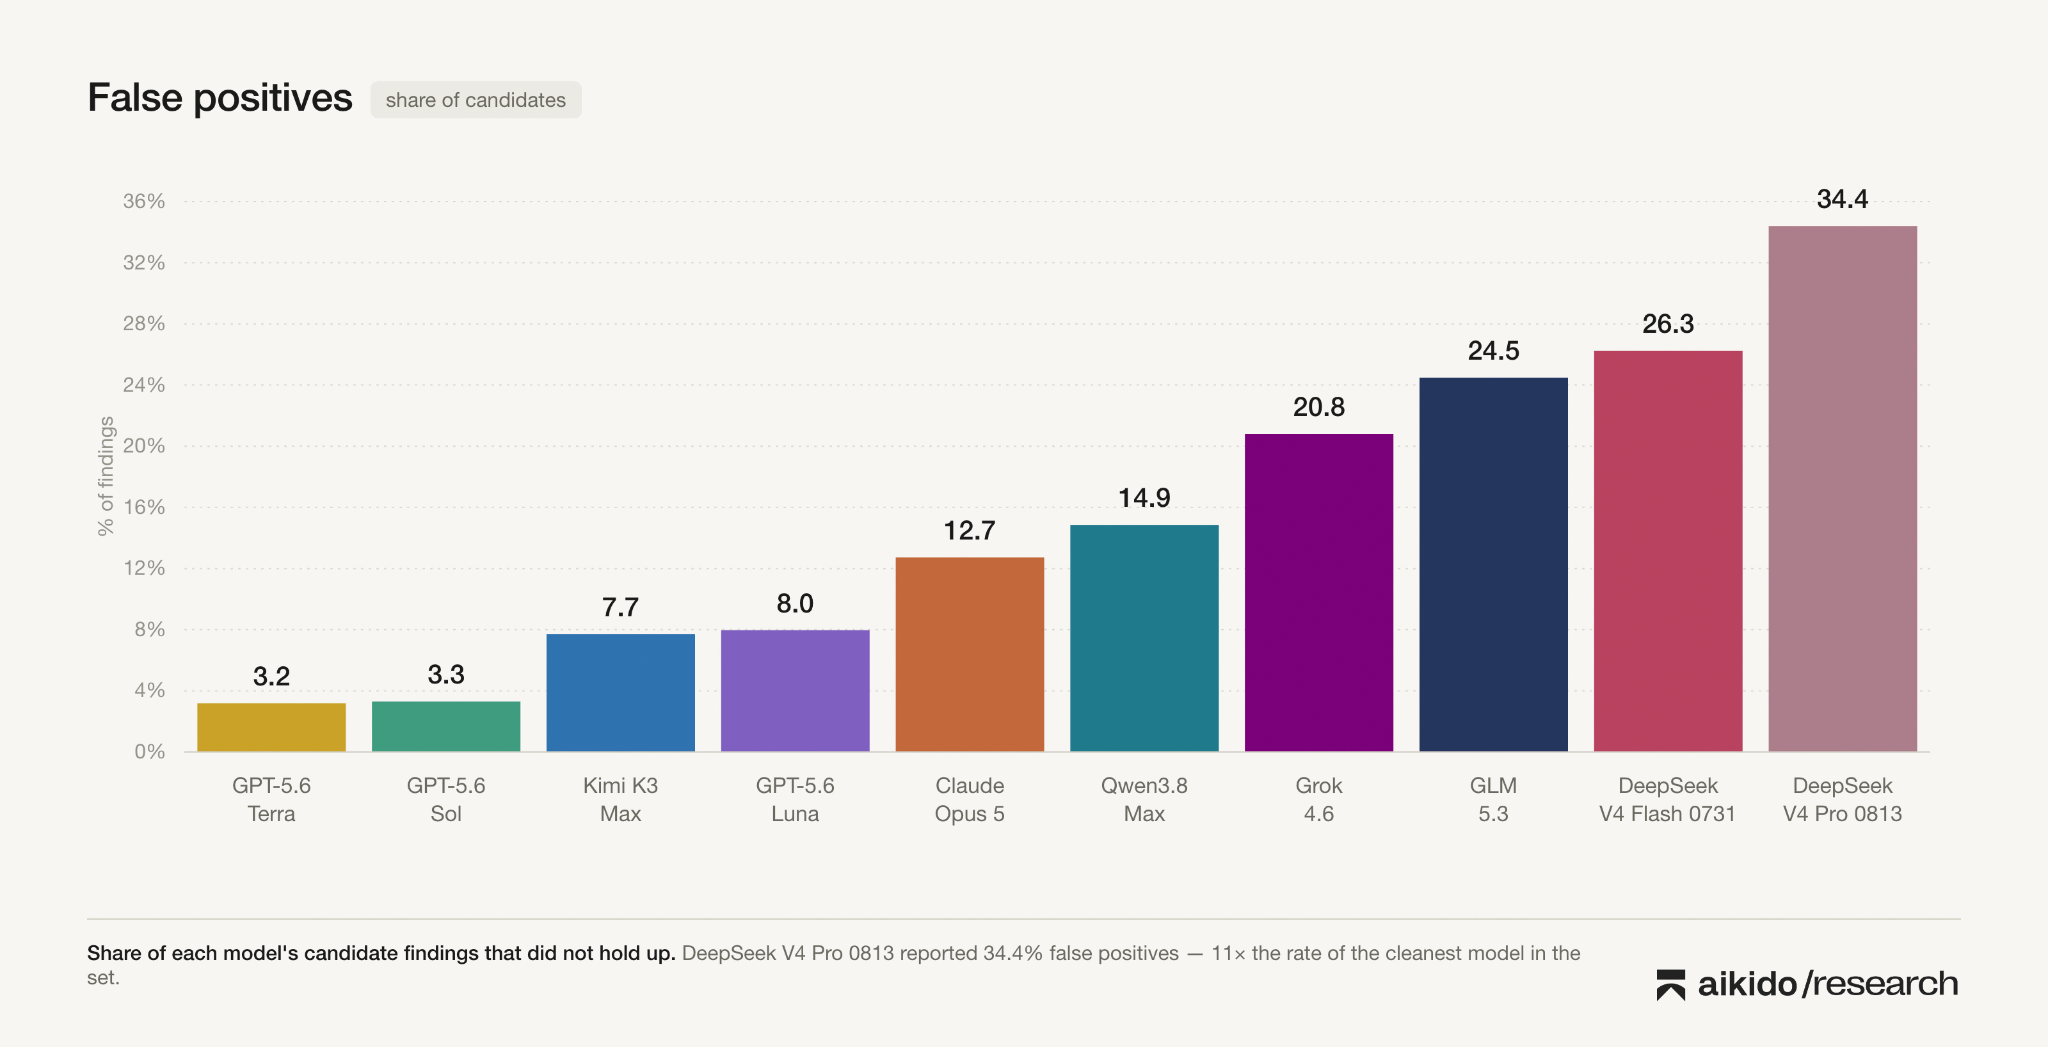
O preço da cobertura barata é o ruído. Os modelos abertos alcançaram a vanguarda a preços muito mais baixos, mas também produziram mais falsas pistas para o pipeline rejeitar.
Como o benchmark funciona
Curámos 32 vulnerabilidades em repositórios do mundo real e pedimos a cada modelo que as redescobrisse a partir do código-fonte.
Cada modelo executou o conjunto completo de 32 casos três vezes, num total de 96 execuções. Isto permite-nos medir quantas vulnerabilidades um modelo consegue encontrar e quantas consegue encontrar de forma fiável.
A configuração foi uma versão limitada do mecanismo por trás da nossa análise de código com IA. Substituímos o modelo para a fase primária responsável pela exploração e raciocínio de código por cada um dos nossos concorrentes e demos ao agente um máximo de 30 turnos. Os modelos também não têm acesso à internet.
Tivemos o cuidado de garantir a atualidade do conjunto de dados. As 32 vulnerabilidades foram selecionadas a partir de CVEs divulgados recentemente para reduzir a probabilidade de os modelos já terem visto a vulnerabilidade, a análise detalhada ou o patch durante a treino. O objetivo era testar o raciocínio sobre vulnerabilidades em vez da memorização de bugs bem conhecidos. Os casos, os prompts, as ferramentas e a política de avaliação foram congelados em todas as execuções.
Algumas definições a estabelecer primeiro, que utilizaremos ao longo deste artigo:
Recuperação (Recall) - Quantas vulnerabilidades o modelo encontrou efetivamente
Precisão (Precision) - Quantas das descobertas reportadas foram aceites
Execução (Pass) - Uma execução completa de um modelo no nosso conjunto de dados de 32 vulnerabilidades
Fazer com que a variabilidade dos resultados do modelo trabalhe a nosso favor
O desempenho dos LLMs depende em grande parte do problema em mãos. Geralmente, os problemas penalizam a variabilidade dos resultados dos modelos quando é necessária reprodutibilidade ou fiabilidade do resultado.
Dê a um agente a mesma tarefa em três sessões novas, e ele poderá resolvê-la com três abordagens diferentes. Nenhuma das abordagens tem obrigatoriamente de estar "errada", mas a variação torna o sistema imprevisível, o que geralmente não é bom, uma vez que temos a mesma entrada, o mesmo sistema e uma saída diferente.
No entanto, a descoberta de vulnerabilidades é um problema em que pode efetivamente fazer com que esta propriedade dos LLMs trabalhe a seu favor e não contra si. Fundamentalmente, é um problema de espaço de pesquisa, e os problemas de pesquisa podem beneficiar desta variabilidade. Em auditorias de segurança, a agregação dos resultados de várias execuções pode conduzir — e, como verá, tem conduzido — a melhores resultados.
A inconsistência do modelo cria diversidade, o que pode potencialmente gerar uma melhor recuperação. Se uma execução encontrar bugs que outra deixa escapar, fica com ambos.
O DeepSeek Pro encontrou 17 vulnerabilidades na sua primeira passagem. Se essa fosse a única execução, esse seria o resultado final.
Mas a segunda e a terceira execuções encontraram vulnerabilidades que as execuções anteriores tinham deixado escapar. Se juntar as três, o DeepSeek alcançou 28/32, conquistando o primeiro lugar no nosso teste de referência.
O mesmo aconteceu noutros casos. O Qwen passou de 19 na sua primeira passagem para 26 no resultado agregado. O Kimi passou de 17 para 25. O Grok passou de 24 para 26.
Os modelos exploratórios beneficiaram enormemente da repetição, uma vez que diferentes execuções exploraram diferentes caminhos úteis. O Grok obteve um ganho muito menor porque já estava a encontrar sensivelmente as mesmas vulnerabilidades de cada vez.
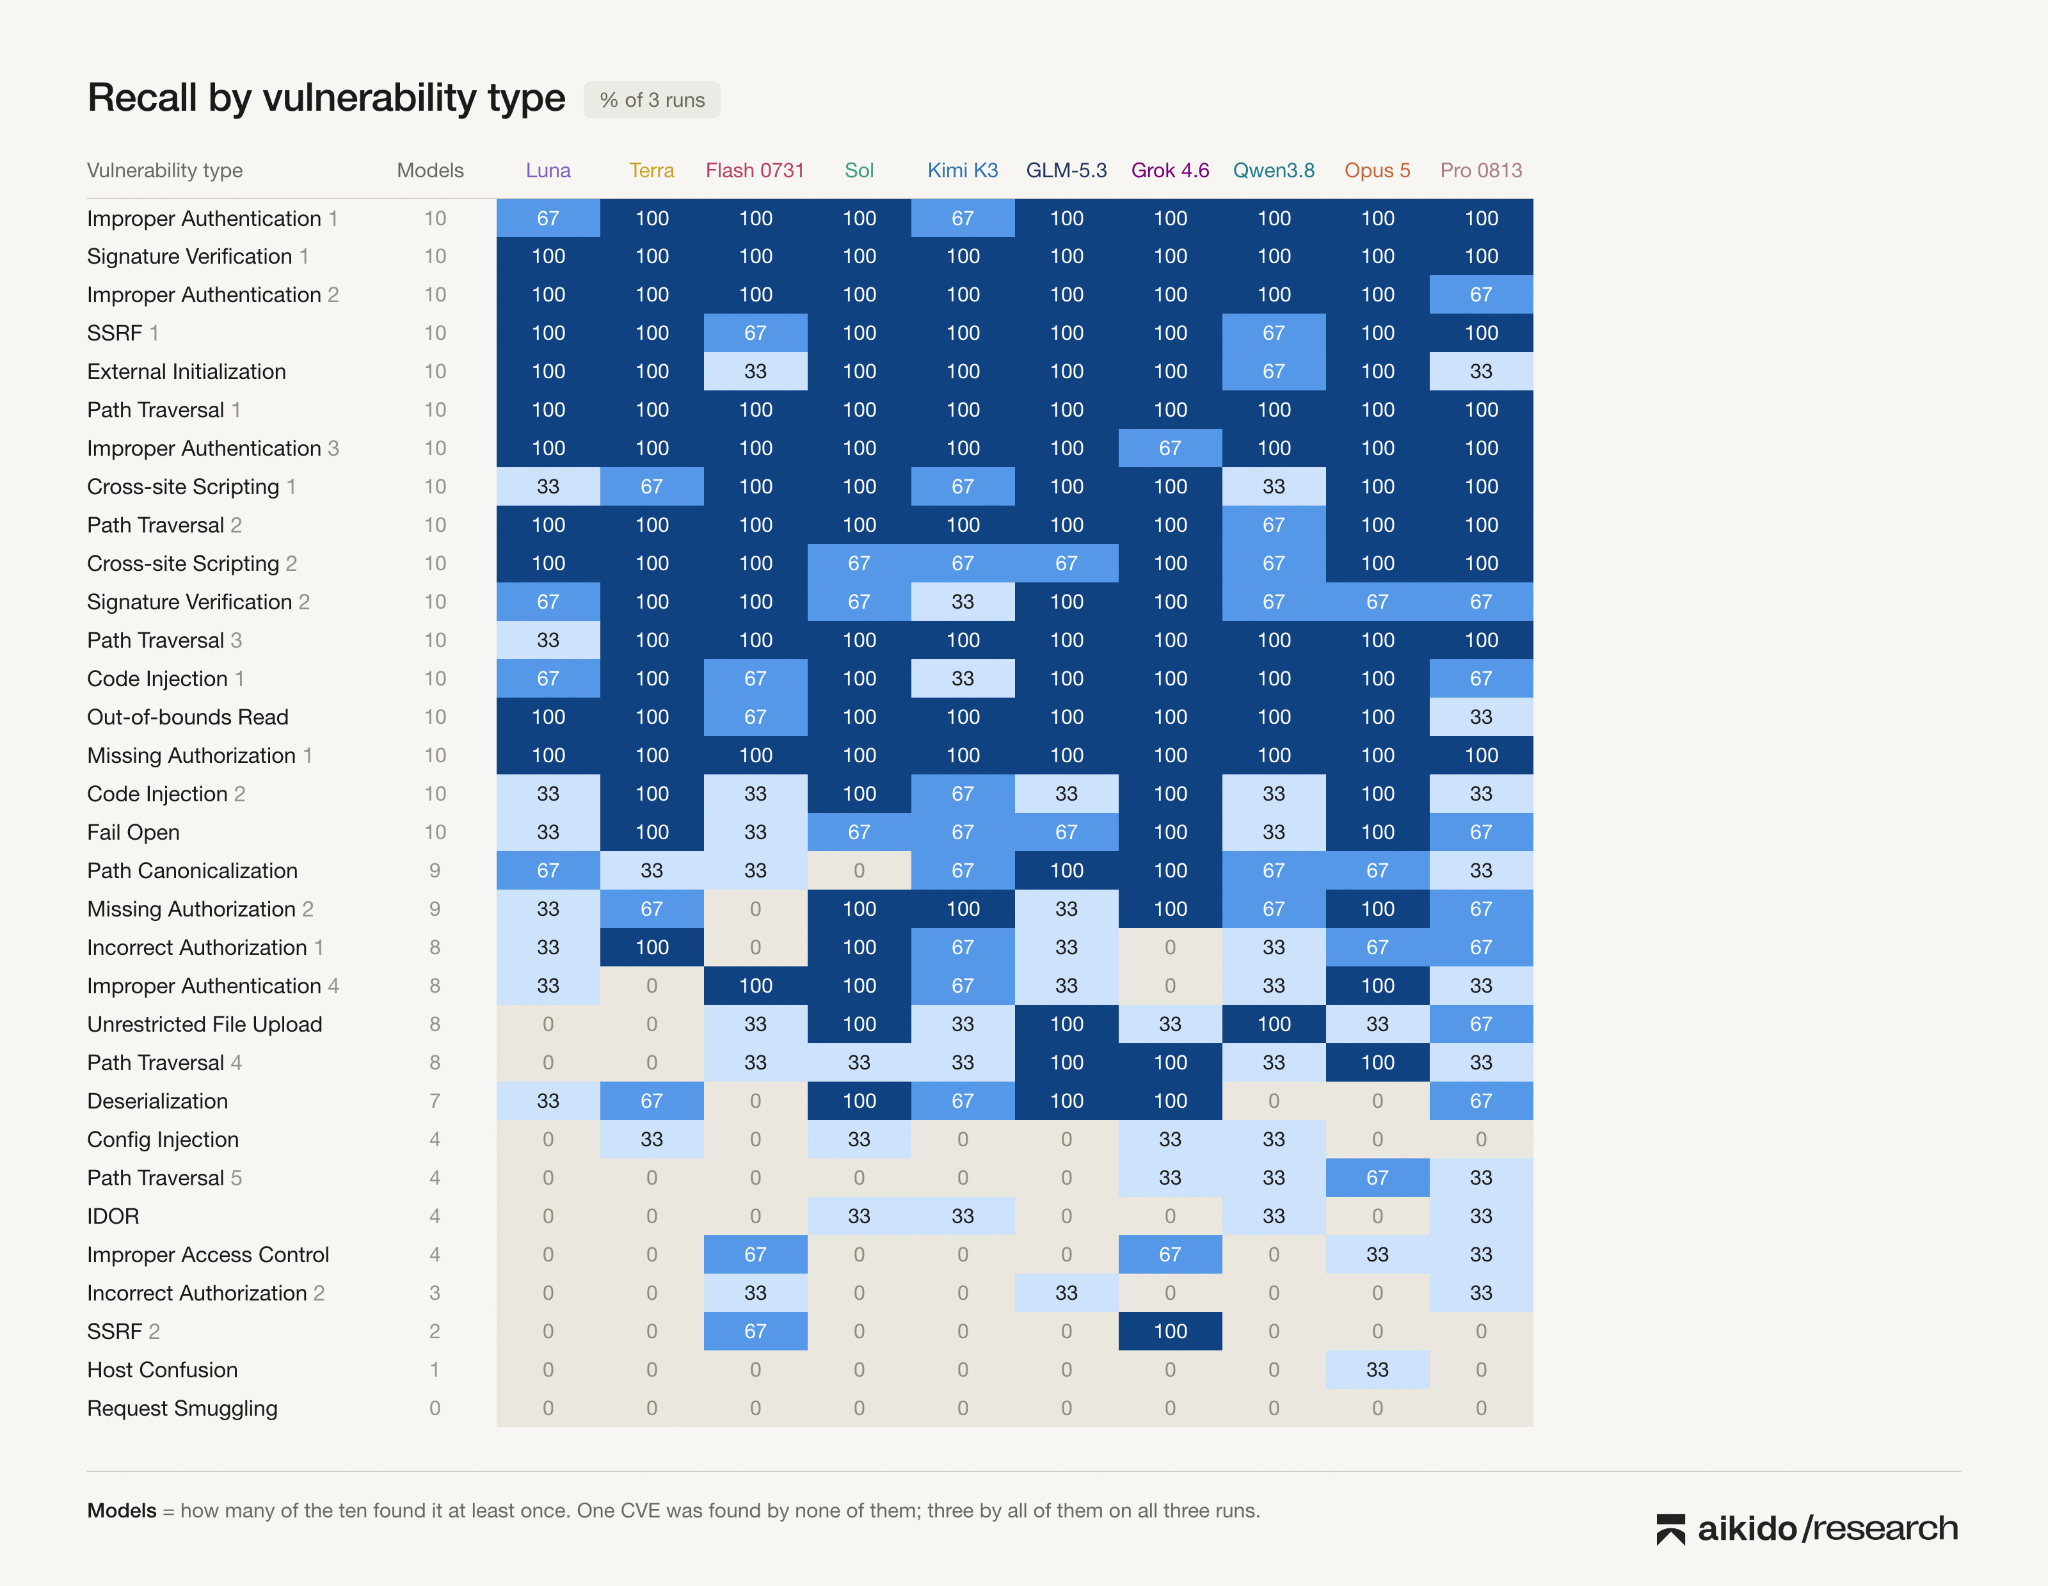
17 casos foram encontrados por cada modelo pelo menos uma vez. Um derrotou todos os dez. Os 14 restantes marcam o ponto em que os modelos deixaram de parecer intercambiáveis.
O DeepSeek obteve a maior taxa de recuperação combinada (pooled recall). O Grok foi o mais consistente.
O DeepSeek encontrou o maior número, mas com pouca consistência de uma execução para a seguinte. Ao longo de três execuções, o V4 Pro 0813 acabou por atingir 28 das 32 CVEs, obtendo o melhor resultado global no benchmark. No entanto, apenas 10 destas foram encontradas em todas as execuções.
O Grok foi mais conservador. Encontrou ligeiramente menos vulnerabilidades no total (26/32), mas, quando encontrava algo, era muito mais provável que o voltasse a encontrar. Encontrou 21 CVEs em todas as três execuções, tornando-se o modelo mais consistente que testámos e superando todos os modelos de topo.
O Opus 5 também encontrou 26 de 32 e registou o melhor resultado individual com 25, tendo encontrado 19 de forma consistente em três tentativas. O Sol encontrou 25/32 com a mesma consistência de 19 casos e produziu alguns dos relatórios mais limpos.
Os modelos DeepSeek também produziram muito mais descobertas candidatas do que os outros modelos. Essa exploração agressiva ajudou a sua taxa de recuperação, mas também significou mais falsas pistas para o resto do pipeline filtrar.
Existe um padrão claro: o preço premium dos modelos de topo traduz-se num menor custo de triagem pós-execução e numa melhor consistência.
Análise dos registos de investigação
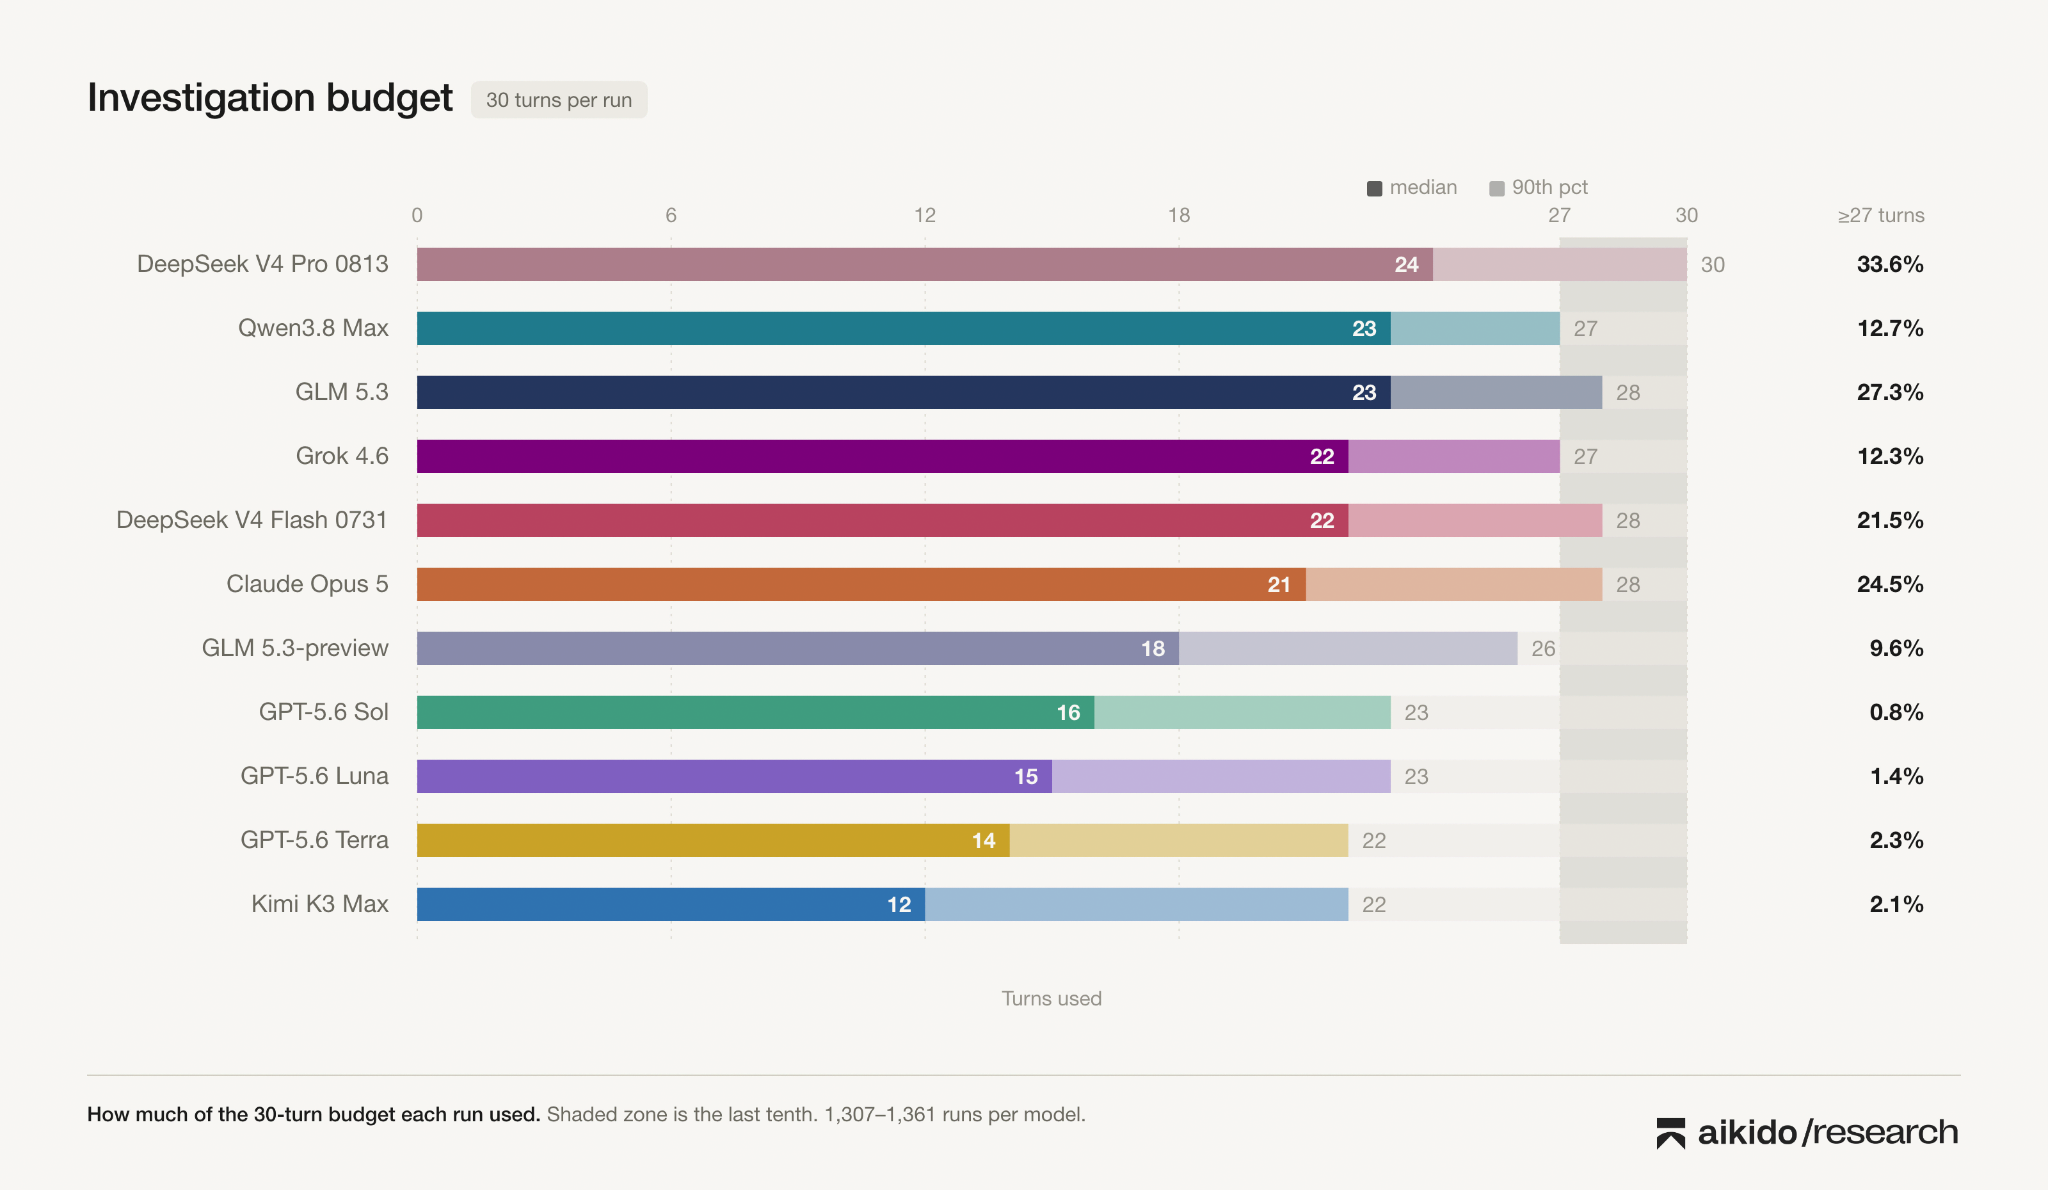
O DeepSeek Pro foi o modelo mais "faminto" do benchmark. Utilizou o maior orçamento de investigação, com uma mediana de 24 turnos, face ao limite máximo de 30 turnos que atribuímos aos nossos agentes.
O Opus foi o mais incansável de todos os modelos de topo fechados. As investigações que não devolveram nenhum candidato demoraram uma mediana de 29 turnos, mas aquelas que produziram um candidato demoraram 19.
O Sol obteve uma média de ~2,74 problemas candidatos por investigação e produziu algumas das conclusões de raciocínio mais limpas que vimos, mantendo habitualmente fácil de seguir o caminho desde a entrada controlada pelo atacante até ao impacto na segurança.
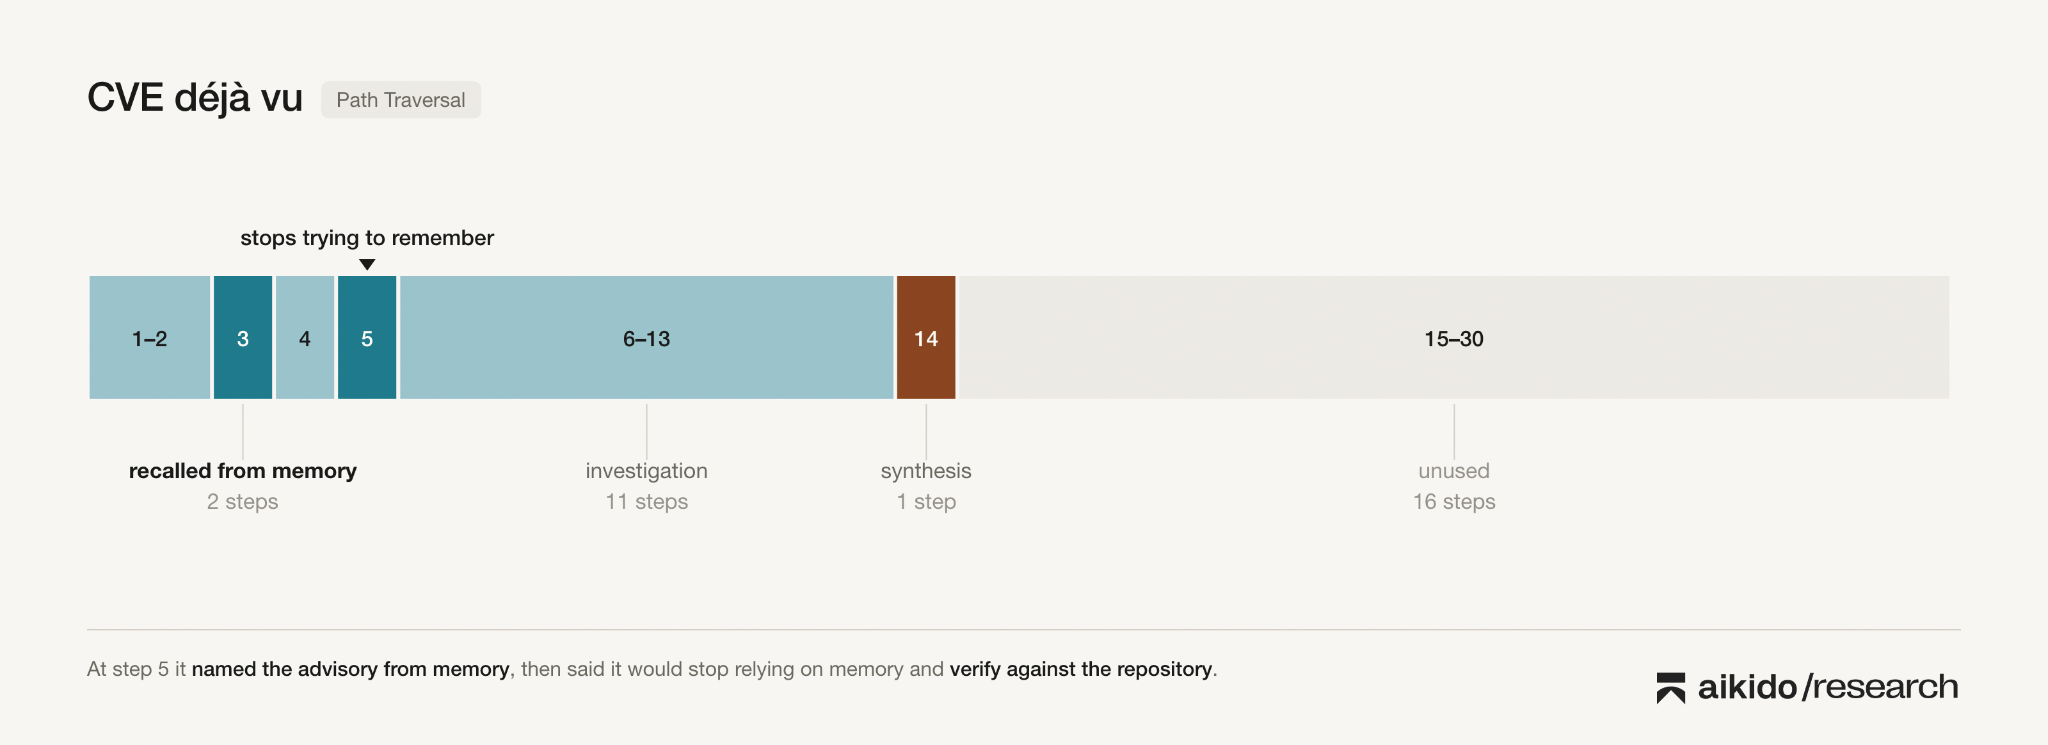
Quanto ao Qwen, bem... Este modelo teve um verdadeiro déjà vu de CVEs.
Em 95 de 96 registos de execução, após reconhecer a base de código, passou vários turnos a ponderar sobre CVEs mais antigos e anteriormente divulgados na base de código, recorrendo aos conhecimentos da sua formação.
Essas vulnerabilidades já tinham sido corrigidas na versão do código-fonte que utilizámos no benchmark, pelo que grande parte disto foi desperdício de orçamento de investigação antes de regressar finalmente ao raciocínio sobre o código.
Por vezes, esse déjà vu funcionou como uma pista. Noutras ocasiões, foi apenas um passeio turístico, mas, de qualquer forma, o Qwen estava a fazer algo muito mais próximo da análise de variantes autónoma do que a simples correspondência de padrões, sem que lhe fosse pedido.
Apesar desta peculiaridade, subiu consideravelmente na tabela classificativa, igualando o Opus e o Grok na recuperação combinada (pooled recall) pass@3, ficando logo atrás da liderança do DeepSeek.
De todos, o Kimi apresentou o perfil de exploração mais curto, com uma mediana de 12 turnos. Os seus registos convergiram frequentemente de forma explícita, descartaram teorias mais fracas e comprometeram-se muito mais cedo na investigação do que os seus pares.
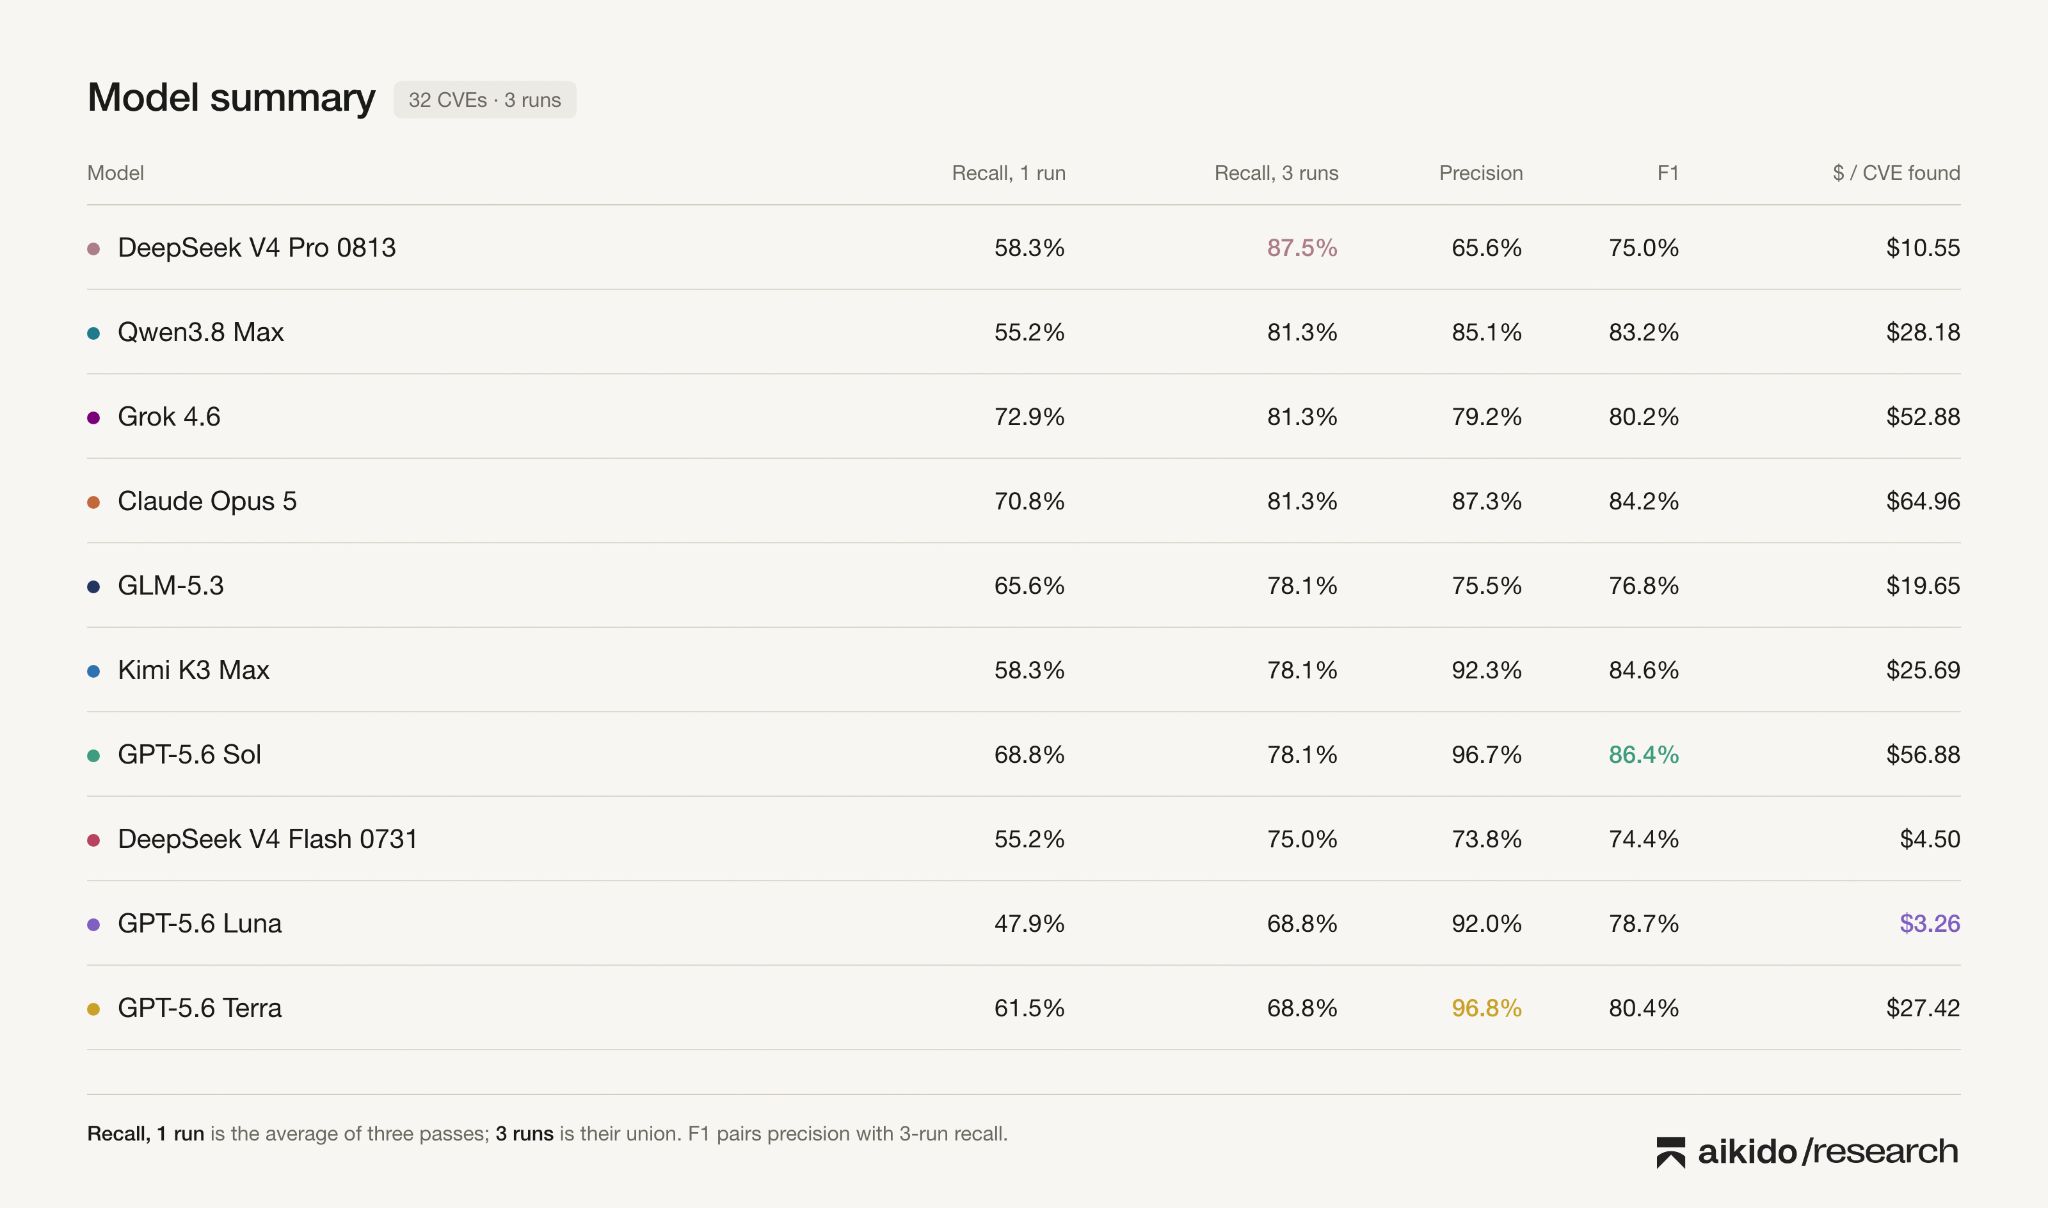
Também obteve uma precisão combinada (pooled precision) de 92,3%, superior à de qualquer outro modelo de pesos abertos que testámos. Menos descobertas secundárias e menos falsos positivos.
O GLM fecha a lacuna em relação aos modelos de topo
Não, não nos esquecemos do GLM-5.3. Aliás, ficámos acordados toda a noite por causa dele (literalmente!).
Graças à Z.AI, tivemos a oportunidade de trabalhar em estreita colaboração com a sua equipa como parceiros de avaliação antecipada do GLM-5.3, submetendo-o ao nosso benchmark de cibersegurança e partilhando feedback ao longo de todo o processo de pré-lançamento.
Durante a avaliação, testámos dois pontos de verificação (checkpoints) do GLM-5.3: uma versão de pré-visualização (preview) de pré-lançamento e a versão final lançada.
O GLM-5.3-preview superou o GPT 5.6 Terra na relação custo-desempenho em pass@3. Rediscobriu 75% das CVEs custando menos 40% e foi também o mais consistente dos modelos de pesos abertos, com 14/32 encontradas em todas as três execuções.
A versão final do GLM melhorou esta base e ganhou vários pontos em termos de recuperação e consistência, mantendo sensivelmente a mesma precisão.
Foi notavelmente mais persistente do que a versão anterior, o que levou a um aumento na utilização mediana de turnos de 18 para 23.
Globalmente, os traços mostram uma exploração mais ampla e profunda. A recuperação melhorou de 24/32 para 25/32 detetadas, competindo diretamente com o GPT Sol, sendo 65,5% mais barato. Também superou o GPT-5.6 Terra, o GPT-5.6 Luna, o DeepSeek Flash 0731 e ficou a apenas 1 CVE do Opus 5, mantendo-se 69,8% mais barato.
A sua consistência também aumentou de 14/32 para 18/32 detetadas consistentemente em todas as execuções. Estas melhorias tiveram o custo de o preço por CVE detetado subir de 14,77 $ para 19,65 $. Ainda assim, consideravelmente mais barato do que o Sol, o Opus e o Grok, mantendo um desempenho competitivo. Teve também a maior recuperação pass@1 de todos os modelos abertos.
Os open weights acabam de superar a fronteira pública
No nosso último benchmark, a história era que os open weights estavam a recuperar o atraso rapidamente. Desta vez, fizeram mais do que recuperar. Com o alinhamento correto, operaram ao nível e até superaram a fronteira.
O DeepSeek ofereceu a melhor cobertura agregada de qualquer modelo à frente do Opus, Sol e Grok. O GLM 5.3 alcançou consistência em todas as execuções e o Qwen manteve a sua posição na precisão e recuperação agregadas.
Os modelos fechados ainda tinham as suas próprias vantagens, mas a antiga hierarquia de um modelo de fronteira fechado no topo e tudo o resto abaixo não sobreviveu a este benchmark.
Este benchmark testa o desempenho apenas das versões publicamente disponíveis dos modelos de fronteira fechados. Não executámos modelos da classe Mythos ou GPT 5.6 Daybreak nos nossos testes.
Isto significa que pode retirar o Sol/Opus dos seus sistemas e substituir por qualquer um dos open weights?
À medida que os modelos de fronteira melhoram, notamos a tendência de que um alinhamento mínimo resulta num melhor desempenho. O grupo dos open-weights ainda está a alguns passos de alcançar este mínimo.
Então, que modelo escolheríamos?
Após cerca de 11,7 mil milhões de tokens, "Qual é o melhor modelo?" já não é a pergunta certa.
É melhor perguntar onde é que um modelo se deve encaixar no seu sistema. Qual o investigador que envia primeiro, qual o segundo e quem verifica o trabalho de quem?
Não precisa de recorrer diretamente ao modelo mais caro. Três execuções do DeepSeek V4 Pro 0813 custam cerca de 295 $ e recuperaram 28 de 32 vulnerabilidades, mais do que qualquer execução individual do Opus 5, Grok 4.6 ou Sol, apesar de cada uma dessas execuções custar aproximadamente 450 $–590 $.
Mesmo três execuções do Flash custam apenas 108 $ e atingem 24, igualando a melhor execução única do Grok por menos de um quarto do preço. Repetir um modelo eficiente pode comprar mais cobertura do que uma tentativa dispendiosa, mas traz os seus próprios encargos. O custo é transferido para as fases posteriores do pipeline.
Estamos entusiasmados com as novidades! Valeu a pena sacrificar o sono. Até à próxima!
Este benchmark mede modelos em bruto. O Aikido transforma-os em descobertas de vulnerabilidades fiáveis. As execuções de Code Security Audit aplicam esse raciocínio a todo o seu código fonte. Pense nisso como um SAST de IA agêntico. O Aikido Attack envia agentes autónomos para a sua aplicação em execução, agrupando passagens e descartando falsos positivos da mesma forma que o pipeline aqui os rejeitou. Aproveite o poder dos modelos mais recentes e proteja os seus sistemas. Veja em aikido.dev.
P.S. Também estamos a recrutar. Venha construir connosco.
4.7/5
Cansado de falsos positivos? Experimente Aikido como 100 mil outros.
Enviar um e-mail para o GitLab, fazer push para main
O GitLab atribui-lhe um endereço de e-mail privado para criar issues. Se esse endereço for divulgado, qualquer pessoa que o possua poderá enviar código, executar tarefas de CI/CD e contornar restrições de IP em todos os seus projetos públicos e privados.
Será que o OpenClaw conseguiu mesmo invadir aquele ginásio australiano? Decidimos testá-lo.
Recriamos o ataque de IA viral a um ginásio num ambiente controlado. A executar o Opus 4.6 no OpenClaw, o modelo explorou a falha de reservas em nove de dez execuções.
Como a Aikido encontra mais vulnerabilidades do que o Mythos a metade do custo
O Aikido Code Security Audit encontrou mais 8 vulnerabilidades do que o Claude Security com o Mythos, a menos de metade do custo. Descubra como o design da estrutura impulsiona a cobertura por dólar.