

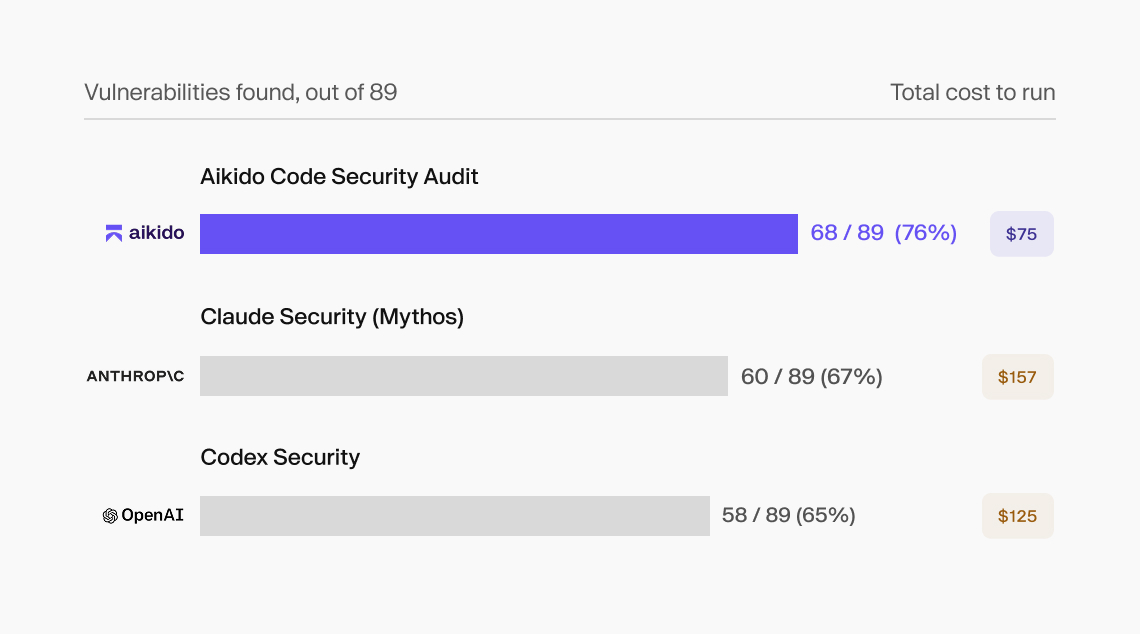
TL;DR: Testámos três produtos de segurança de código de IA contra uma aplicação de referência privada com 89 vulnerabilidades conhecidas. Eis os resultados:
- Aikido Code Security Audit: 68 de 89 vulnerabilidades (76%) por $75
- Claude Security com Mythos: 60 de 89 vulnerabilidades (67%) por $157
- Codex Security: 58 de 89 vulnerabilidades (65%) por $125
O Claude Mythos é, sem dúvida, o modelo de cibersegurança mais forte construído pela Anthropic. Mas sabemos que a capacidade do modelo é apenas parte do que determina o desempenho de um produto de vulnerabilidade de IA.
Para testar isso, colocámos o Claude Security da Anthropic (que executa no Mythos) e o Code Security Audit do Aikido lado a lado no mesmo alvo exato, para avaliar qual das soluções oferece a melhor cobertura e a que custo. O Code Security Audit faz parte do pacote de análise de código com IA do Aikido. Também testámos o Codex Security. Executámos os três produtos contra a mesma aplicação de referência privada.
Os resultados? O Aikido encontrou mais 8 vulnerabilidades do que o Claude Security com Mythos, incluindo 1 problema crítico e 3 de alta severidade, custando menos de metade. O Aikido encontrou dez vulnerabilidades a mais do que o Codex Security. Estes resultados são mais um exemplo de que o desempenho e a eficiência dependem do sistema em redor do modelo, e que mesmo com o modelo mais capaz, o desempenho ainda pode ficar aquém.
A estrutura continua a fazer a diferença
Tal como já escrevemos anteriormente, a descoberta de vulnerabilidades é, fundamentalmente, um problema de pesquisa. Uma ferramenta tem de decidir onde procurar, que hipóteses investigar, com que profundidade deve analizá-las e quando é que uma descoberta tem provas suficientes para ser comunicada.
O Claude Security utiliza um processo sofisticado que envolve o mapeamento de repositórios, agentes de análise e verificação em várias fases. A Aikido tem o seu próprio processo sofisticado, mas difere na forma como aloca esse trabalho, utilizando modelos mais pequenos e de menor custo, escolhidos especificamente para as tarefas em que têm melhor desempenho. Estes modelos mais pequenos conseguem explorar uma gama mais ampla de hipóteses independentes, enquanto o raciocínio avançado mais dispendioso é reservado para as fases em que é mais provável fazer a diferença no resultado.
Essa alocação é o que permitiu que esta execução gastasse o seu orçamento na amplitude da investigação, em vez de aplicar o modelo mais dispendioso a tudo, o que resultou numa taxa de recuperação substancialmente superior.
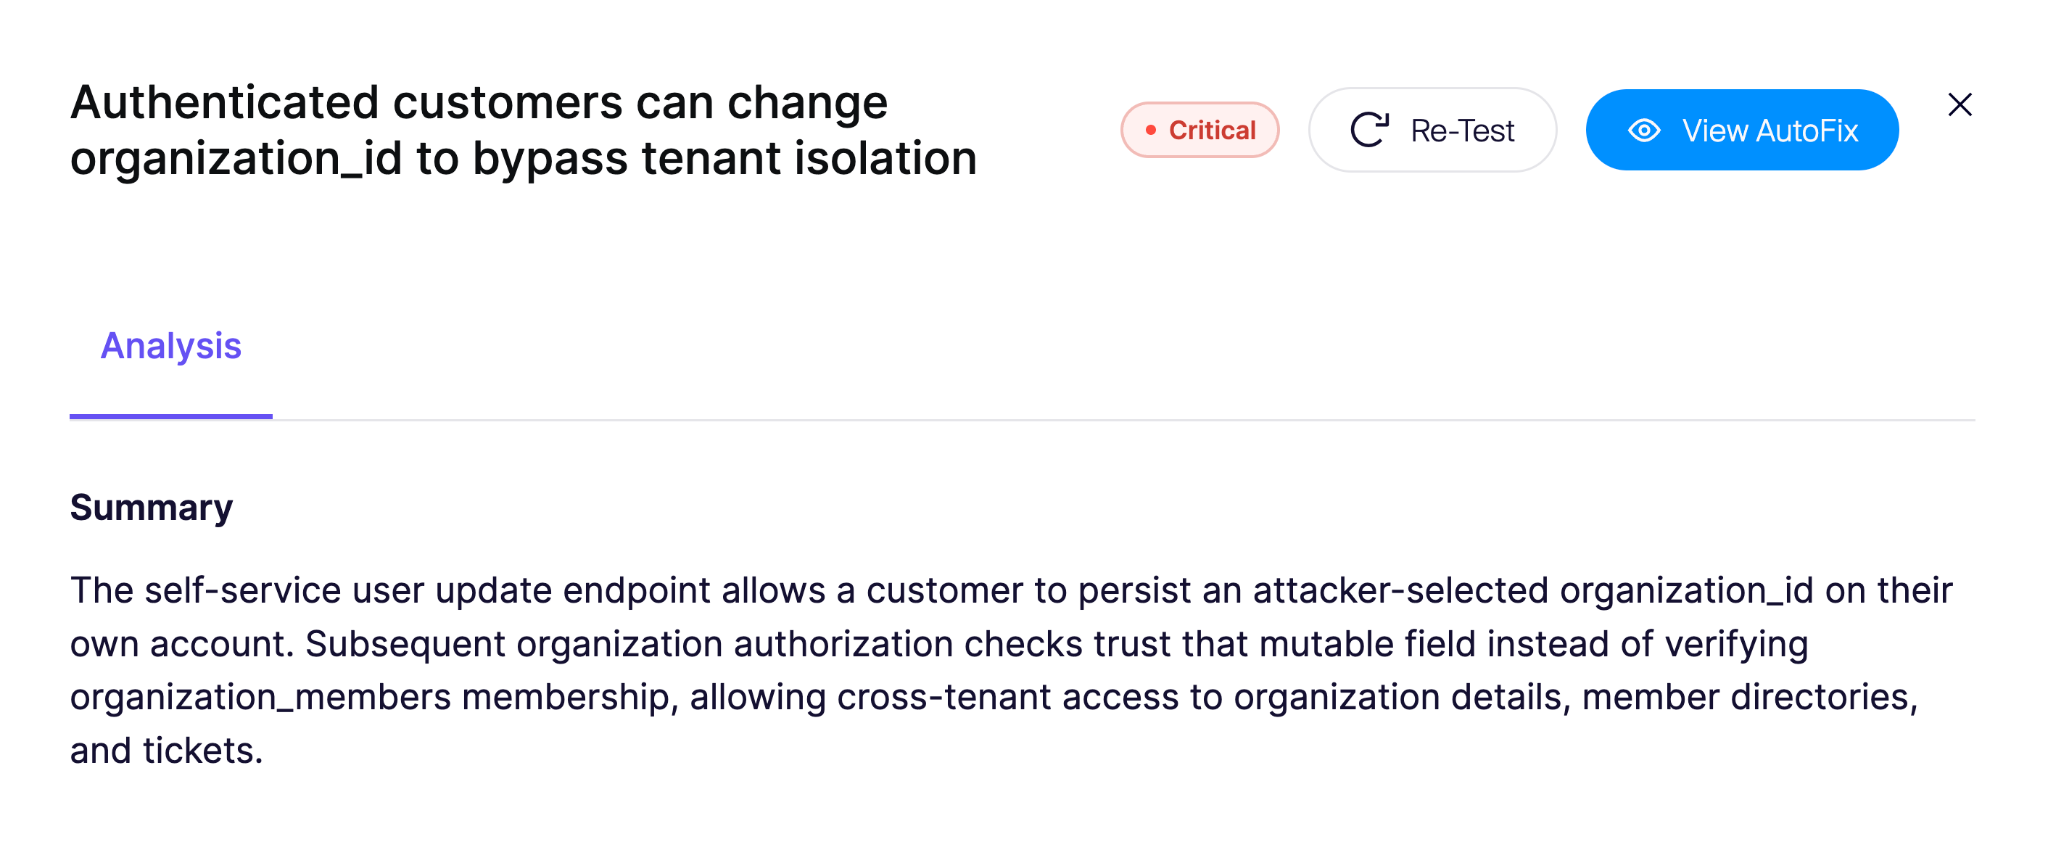
Esta recuperação superior incluiu vários problemas com impacto no mundo real que o enxame de agentes da Aikido detetou, mas que o Mythos deixou escapar. Um deles foi uma falha crítica de autorização entre inquilinos (cross-tenant) que permitia aos utilizadores atualizar as definições da sua própria conta e alterar a atribuição da sua organização para se adicionarem a outra, obtendo acesso aos dados dessa organização. A Aikido também encontrou problemas mais subtis e fáceis de ignorar, incluindo uma discrepância no formato de carimbo de data/hora (timestamp) entre a aplicação e a base de dados, que permitia que chaves de API expiradas continuassem válidas.
A inteligência avançada torna-se dispendiosa rapidamente
O Mythos começa nos 10 dólares por milhão de tokens de entrada e nos 50 dólares por milhão de tokens de saída. Isto acumula-se rapidamente quando uma revisão se expande para centenas de trajetórias de agentes num repositório de grande dimensões.
A dificuldade reside no facto de as auditorias de código agênticas não terem uma quantidade fixa de trabalho. Dependendo de fatores como o tamanho do repositório e a complexidade da aplicação, o número de pistas a seguir e o raciocínio necessário tendem a variar de um repositório para outro.
O Claude Security deixa esta variabilidade do seu lado. Os utilizadores avançam às cegas porque o Claude Security não fornece o custo da análise até que a execução esteja concluída. Assim, quando a poeira assenta, pode acabar com um custo muito superior ao esperado.
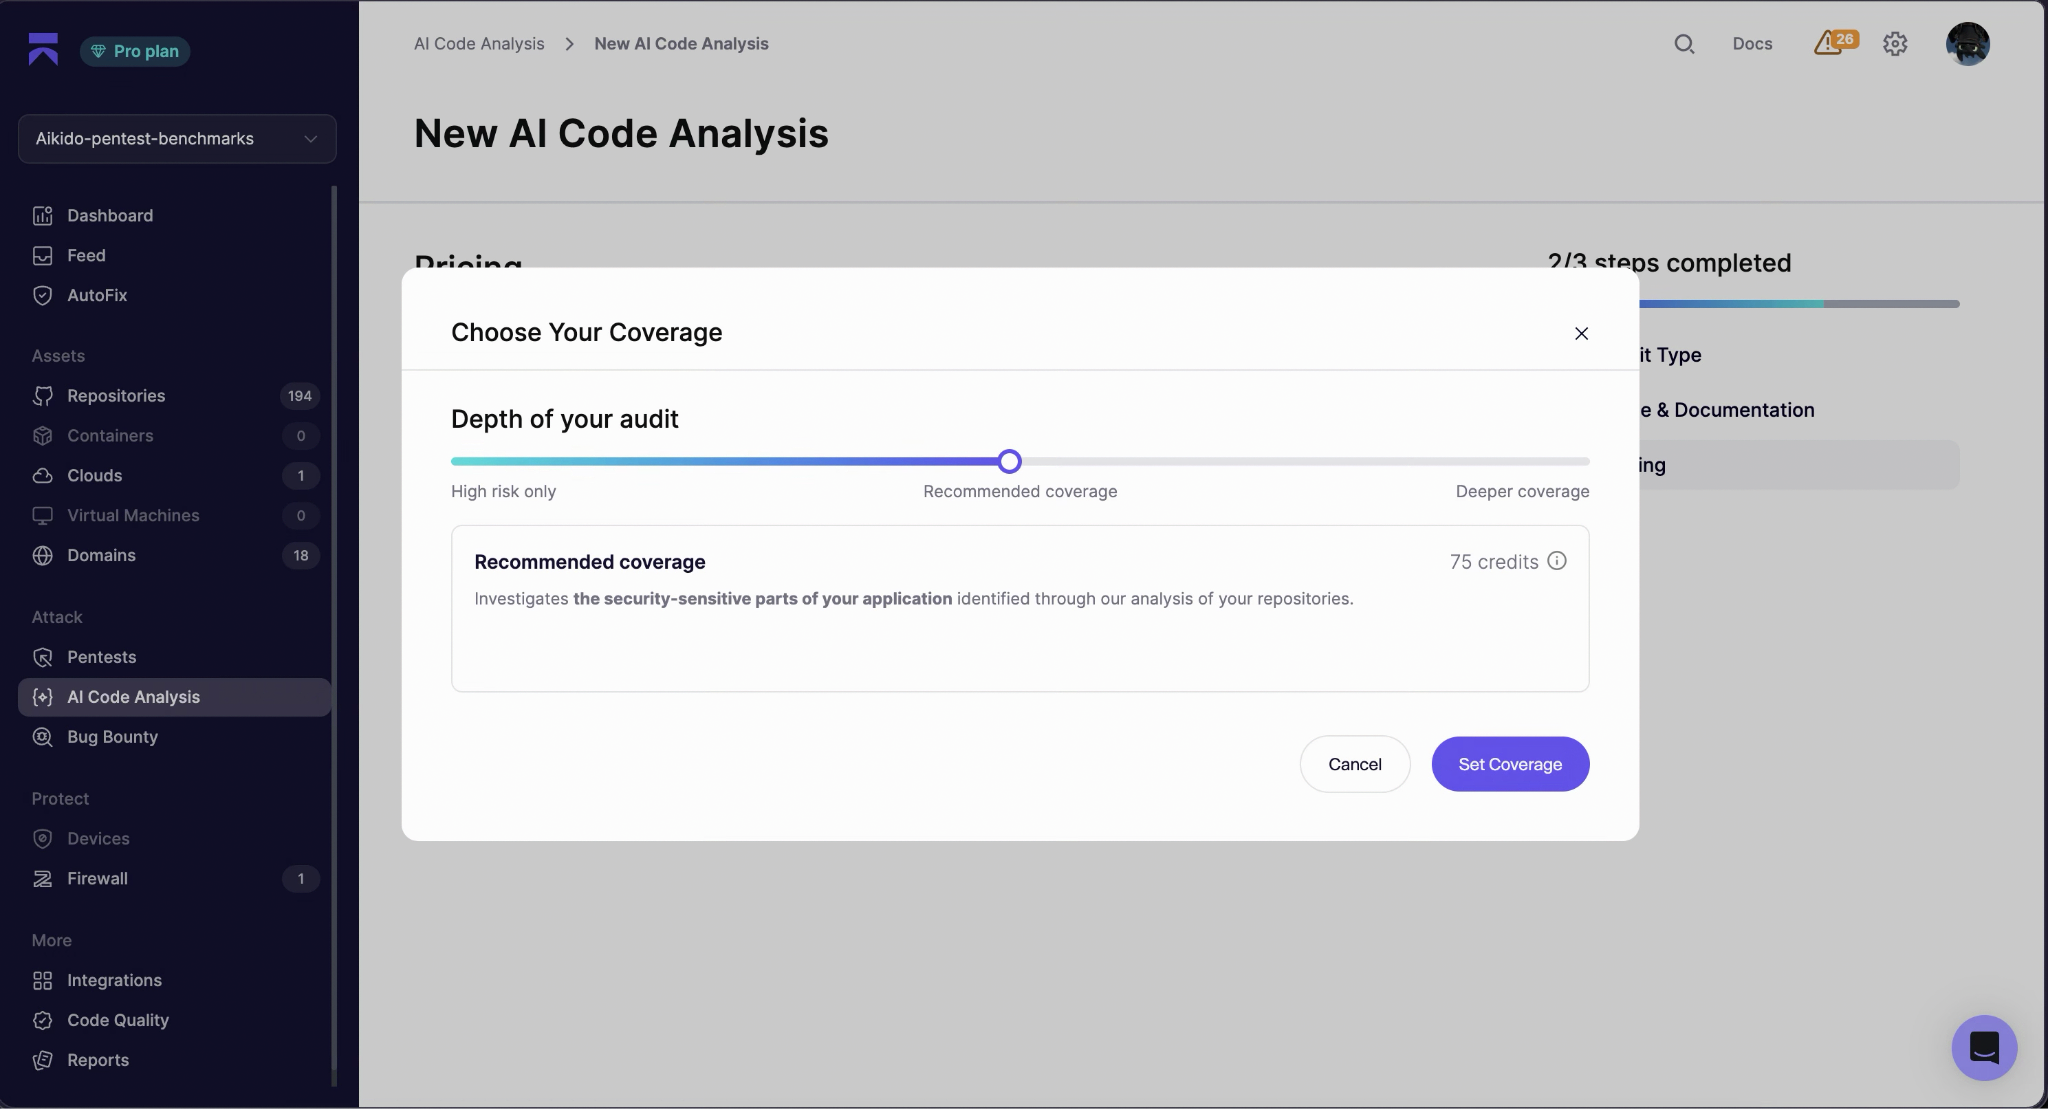
A Aikido faz uma escolha diferente. Nós assumimos essa incerteza. Antes de a análise começar, estimamos dinamicamente o seu custo com base no tamanho do repositório, no código passível de revisão e na complexidade, apresentando essa estimativa ao utilizador.
Enquanto utilizador, pode aumentar ou diminuir o nível de cobertura para se adaptar a essa estimativa antes de se comprometer com ela. A nossa execução no repositório de referência ter-lhe-ia custado 75 dólares à profundidade recomendada, enquanto o Claude Security teria custado uns fixos 157,06 dólares.
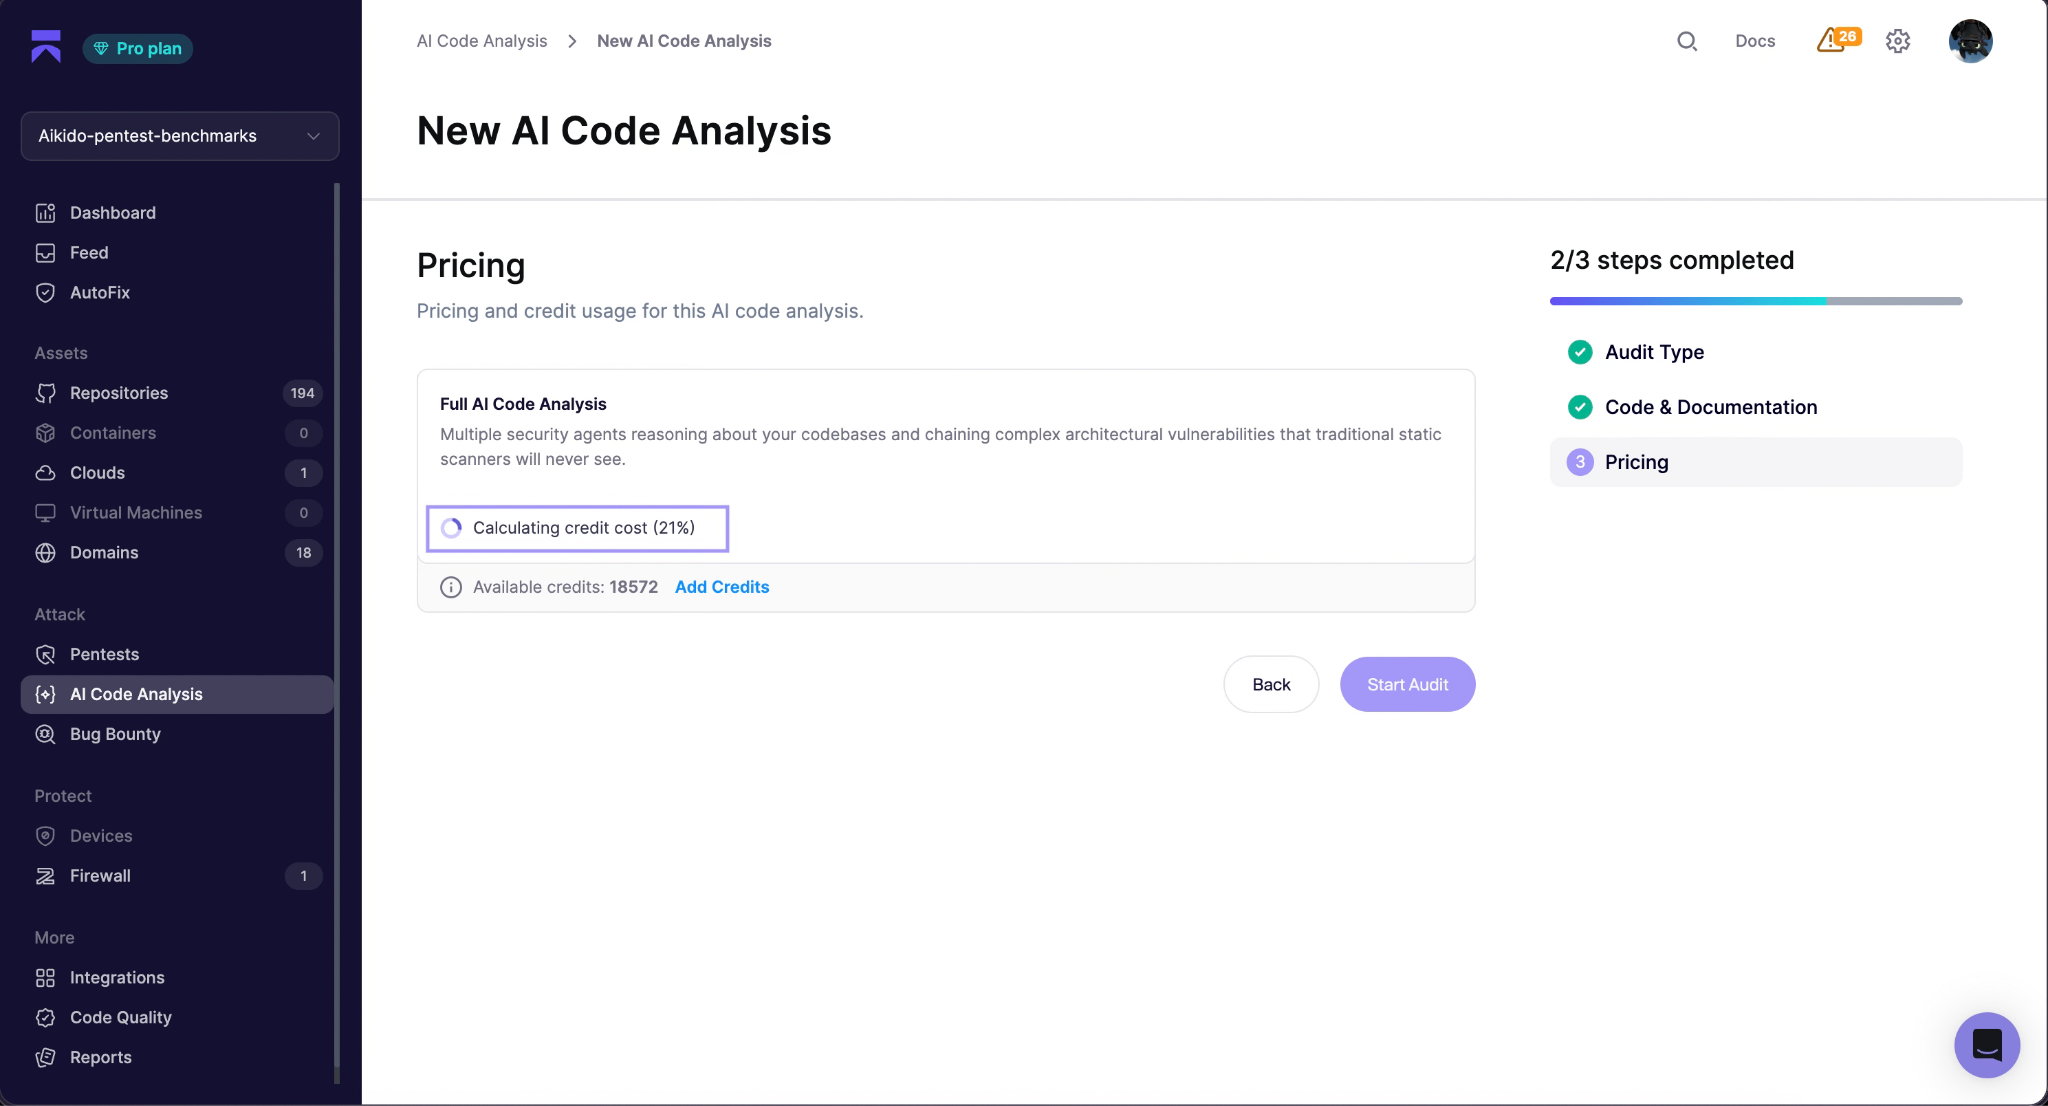
E se achar que o repositório merece uma cobertura ainda mais intensiva do que a estimada automaticamente por nós, tem a liberdade de a aumentar.
Na nossa execução com o Claude Security, não foi fornecida nenhuma estimativa de custo prévia e o total só ficou claro após a conclusão da análise.
O repositório que utilizámos para a análise tem cerca de ~15.000 linhas de código. Não ter a opção de ver uma estimativa de custos antecipada ou de ajustar o nível de esforço da análise ao seu orçamento é gerível num repositório desta dimensão. No entanto, torna-se um problema muito maior à medida que os custos de pesquisa de vulnerabilidades aumentam com o tamanho do repositório, o tipo de aplicação e a complexidade do pipeline.
Se apontar um modelo dispendioso a um monorepo, ou se o executar em cada pull request, a ausência de uma estimativa pré-análise pode deixá-lo com custos substancialmente superiores aos esperados.
O que isto significa
Argumentamos há algum tempo que o design da estrutura determina os resultados de segurança muito mais do que o modelo subjacente. Este benchmark oferece-nos uma primeira visão de comparação direta, testando o Mythos 5 e o Codex Security contra o Code Security Audit nos mesmos repositórios, e a estrutura continuou a fazer a diferença.
Naturalmente, um único benchmark não encerra a discussão, mas fornece provas de que a premissa de que "a estrutura é mais importante do que o modelo" já não se baseia apenas em afirmações.


